PaddleOCR Online · Keine Installation, öffnen und loslegen

Jedes Dokument
in Markdown umwandeln

Von PDFs und Scans bis hin zu Word, Excel und PowerPoint: PaddleOCR liest alle diese Formate ein und stellt Überschriften, Absätze, Tabellen, Formeln und Diagramme in ihrer ursprünglichen Lesereihenfolge wieder her. Die Ausgabe erfolgt als Markdown und JSON mit Koordinaten, Formeln werden als LaTeX und Molekülstrukturen als SMILES wiederhergestellt. Tabellen bleiben auch über Seitenumbrüche hinweg und bei verbundenen Zellen vollständig erhalten. Unterstützt werden über 100 Sprachen. Die Modelle laufen in der Cloud und sind jederzeit abrufbar. Mit API-Zugriff lässt sich in nur einer Minute eine Pipeline zur Dokumentenübernahme einrichten.

Seiten werden täglich analysiert
1.2M+
Seiten werden täglich analysiert
Unterstützte Formate
30+
Datei- und Webformate
Dienstverfügbarkeit
99.9%
Dienstverfügbarkeit

PaddleOCR Arbeitsbereich

Hochladen · Analysieren · Exportieren, alles an einem Ort

PDF / DOCX / PPTX / XLSX / HTML / PNG

Dateien bis zu 10 MB · Bilder bis zu 5 MB · PDFs bis zu 5 Seiten Upgrade auf Pro

Nur für PDF. Aktiviert: vorhandene Textebene ignorieren und OCR nutzen. Deaktiviert: automatisch erkennen. Andere Formate bleiben unverändert.
Exportformate Markdown · JSON · HTML · DOCX · LaTeX

Aufgabenliste

Melden Sie sich an, um Ihre Aufgaben anzuzeigen

Ihre Dokumente und Ergebnisse gehören zu Ihrem Konto.

Anmelden

Parsen in Aktion

Sehen Sie, was von einer echten Seite zurückkommt

Wenn Sie das gleiche Dokument übergeben, erhalten Sie mit einer generischen OCR eine Textwand. PaddleOCR behält die Struktur, die Chemie und die Mathematik bei.

Fall 01 · Chemische Strukturen

Molekulares Diagramm → durchsuchbare, berechenbare Chemie

Strukturen werden nicht mehr als Bilder weggeworfen. PaddleOCR liest Ringsysteme und Substituenten und gibt dann SMILES, Summenformeln und LaTeX aus.

Originalseite PDF
Scheme 2. J. Med. Chem. 2026, 49, 1128 Fig. 2. Structure of paracetamol HO NHCOCH3
PaddleOCR Ausgabe
>
# structure → structured chemistry

{

  "type": "chemical_structure",

  "smiles": "CC(=O)Nc1ccc(O)cc1",

  "formula": "C8H9NO2",

  "iupac": "N-(4-hydroxyphenyl)acetamide",

  "latex": "\ce{CH3CONH-C6H4-OH}"

}


# inline Markdown output

Paracetamol ($C_8H_9NO_2$, SMILES: CC(=O)Nc1ccc(O)cc1)
Generische OCRDas Diagramm wird als Bild gelöscht – alles, was übrig bleibt, ist „siehe Abb. 2“. Keine Suche, keine Berechnung.
PaddleOCRWiederhergestellt als SMILES / Formel / LaTeX – bereit zum Indizieren, Abfragen und Ausführen von Eigenschaftsberechnungen.
Fall 02 · Mathe

Formeln → clean LaTeX

Indizes, Radikale, Brüche und griechische Buchstaben bleiben erhalten – die Ausgabe wird unverändert kompiliert.

Originalseite PDF
PaddleOCR Ausgabe
>
# standard LaTeX, renders as-is

\int_{0}^{\infty} e^{-x^{2}}\,dx

= \frac{\sqrt{\pi}}{2}


\frac{\pi^{2}}{6}

= \sum_{n=1}^{N} \frac{1}{n^{2}}


# human-readable text kept too

∫₀^∞ e^(−x²) dx = √π / 2
Fall 03 · Komplexe Tabellen

Zusammengeführte Kopfzeilen und übergreifende Tabellen → strukturierte Zeilen

Mehrstufige Überschriften und Tabellen, die sich über mehrere Seiten erstrecken, werden wieder zusammengefügt, wobei die Zellkoordinaten intakt bleiben.

Originalseite PDF
Table 3. Yield comparison, control vs. treatment Group Control Treatment Mean SD Mean SD Sample A 12.4 0.83 18.9 1.02 Sample B 14.1 0.91 21.3 1.14 Sample C 15.7 1.05 24.6 1.28 Sample D 17.2 1.11 26.8 1.35
PaddleOCR Ausgabe
>
# merged headers flattened to Markdown

| Group | Control mean | Control SD | Treatment mean | Treatment SD |

| --- | ---:| ---:| ---:| ---:|

| Sample A | 12.4 | 0.83 | 18.9 | 1.02 |

| Sample B | 14.1 | 0.91 | 21.3 | 1.14 |

| Sample C | 15.7 | 1.05 | 24.6 | 1.28 |

| Sample D | 17.2 | 1.11 | 26.8 | 1.35 |


# coordinates & merges kept in JSON

{"rows": 5, "cols": 5, "merged": [2, 2]}

Fähigkeiten

Eine Parsing-Engine für komplexe Dokumente

Über die Textextraktion hinaus. PaddleOCR versteht die Struktur, Semantik und Hierarchie wissenschaftlicher Layouts.

Chemie · Mathematik · Tabellen

01 / WISSENSCHAFT

Wissenschaftliches Layoutverständnis

Speziell entwickelt für chemische Formeln, mathematische Notation, komplexe Tabellen und mehrspaltige Layouts – unter Beibehaltung der Lesereihenfolge und der logischen Struktur.

Chemische FormelnLaTeX MatheSpannende Tabellen
{ "type" : "title" , "level" : 1 "bbox" : [ 72, 96, 540 ], "text" : "3. Methods" }, "type" : "table" , "html" : "<table>…" }, …] Semantik · bbox · Hierarchie

02 / AGENTEN

Heimisch für KI-Agenten

Strukturiertes JSON mit semantischen Tags für Überschriften, Absätze, Tabellen, Abbildungen und Formeln – direkt in RAG, Wissensdatenbanken und Agenten-Workflows einbinden.

Strukturiert JSONRAG-bereitSemantische Tags
Layout 0.42s Formulas 0.61s Tables 0.77s 100 Seiten · 1.8s insgesamt

03 / GESCHWINDIGKEIT

Elastische Hochgeschwindigkeitsberechnung

Elastic Cloud Scheduling analysiert hundertseitige Dokumente in Sekundenschnelle, während Batch-Jobs parallel ausgeführt werden, um den Unternehmensdurchsatz zu erfüllen.

SekundenjobsParallele ChargenElastische Skalierung

Wer verwendet PaddleOCR

Entwickelt für Forschungs-, Ingenieur- und Geschäftsteams

Von der Leseliste einer Person bis hin zu einer unternehmensweiten Wissensdatenbank sitzt PaddleOCR am ersten Tor, wo Dokumente in Ihre Systeme gelangen.

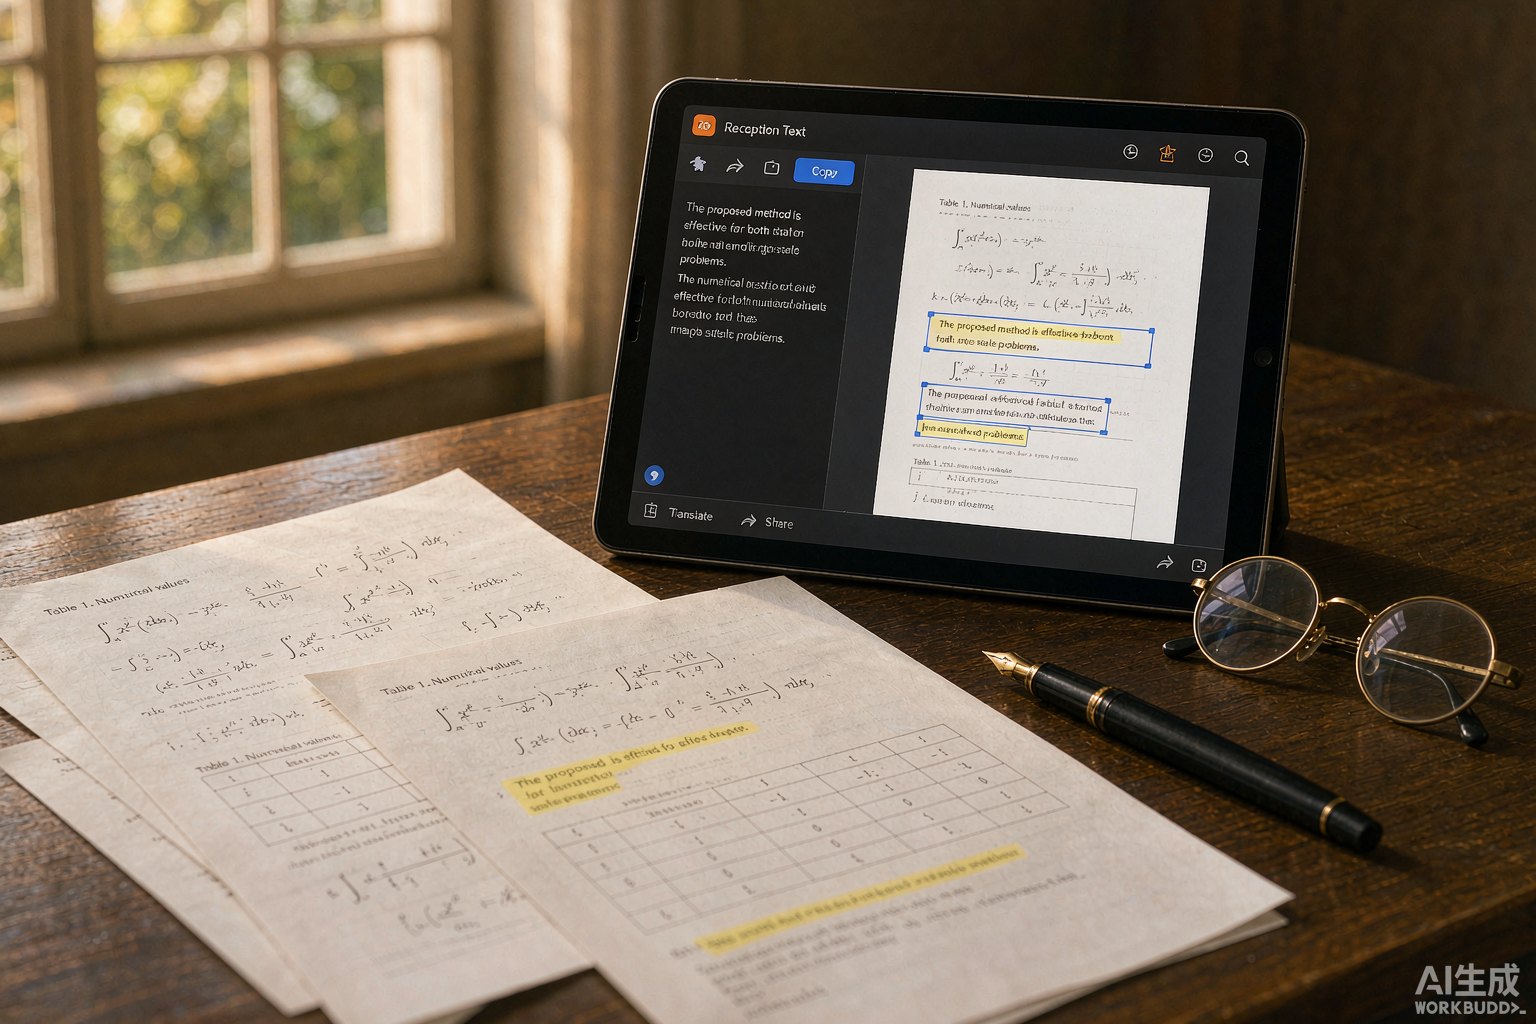
Ein wissenschaftlicher Forscher nutzt PaddleOCR online, um PDF Aufsätze und Literatur in strukturierten Text zu analysieren

Forscher

Wissenschaftliche Forscher

Verwandeln Sie Papiere, Patente und Labornotizen in großen Mengen in durchsuchbaren strukturierten Text. Formeln und chemische Notation bleiben erhalten, sodass Literaturrecherchen keine manuelle Transkription mehr sind.

Ein Entwickler ruft das Dokument PaddleOCR auf, analysiert API und verbindet die Ergebnisse in eine Anwendung

Entwickler

KI-Anwendungsentwickler

Eine Codezeile. Integrieren Sie semantisch markierte JSON direkt in Ihre RAG-Pipeline, Wissensdatenbank oder Ihren Agenten-Workflow – Sie müssen keine eigene Parsing-Pipeline pflegen.

Ein Team überprüft Analyseanalysen und Dashboards zur Dokumentenanalyse auf einem großen Bildschirm im Besprechungsraum

Unternehmen

Unternehmens- und institutionelle Teams

Batch-Aufnahme von Forschungsberichten, Verträgen und Archiven. Kombinieren Sie es mit On-Premise-Bereitstellungs- und Nutzungsberichten, um Dokumentbestände wirklich durchsuchbar zu machen.

API Referenz

Integrieren Sie es in eine Zeile und rufen Sie es wie eine lokale Funktion auf

Ein RESTful API und ein mehrsprachiges SDKs decken Upload, Status und Download ab – mit klaren Fehlercodes und Webhooks, damit die Integration problemlos bleibt.

  • RESTful Endpunkte mit cURL / Python / Node.js / Go Beispielen
  • Wählen Sie synchrone Antworten oder asynchrone Jobs
  • Strukturierte Fehlercodes mit Anleitung für Wiederholungsversuche
  • Webhook-Rückrufe nach Abschluss, keine Abfrage erforderlich
Lesen Sie die vollständigen API-Dokumente
>
import requests

api = "https://api.example.com/api/open/v1"
headers = {"Authorization": "Bearer YOUR_API_KEY"}
with open("paper.pdf", "rb") as file:
    response = requests.post(api + "/tasks", headers=headers,
        files={"file": ("paper.pdf", file, "application/pdf")},
        data={"force_ocr": "true", "extra_formats": '["docx","html"]'})
response.raise_for_status()
body = response.json()
if body["code"] != 0: raise RuntimeError(body["msg"])
task = body["data"]
print(task["task_id"])
# GET /tasks/{id}; download results.full_zip_url when completed

Preise

Auswahl nach Verwendung, jederzeit wechseln

Online-Parsing und alle fünf Exportformate. Wählen Sie den Plan, der zu Ihren Unterlagen passt.

Free

Melden Sie sich an und starten Sie sofort

$0/ Monat

Keine Zahlungsmethode erforderlich

  • 5 kostenlose Seiten jeden Tag
  • PDF, Word, PPT, Excel, Bilder, HTML
  • Dateien bis zu 10 MB · Bilder bis zu 5 MB
  • PDFs mit bis zu 5 Seiten
  • Webzugriff; API ist nicht enthalten
Kostenlos starten

Pro · Monatlich

Flexibler Zugriff, jeweils einen Monat lang

$9.90/ Monat

USD · einmalige Zahlung

  • 1,000 Seiten jeden Monat
  • PDF, Word, PPT, Excel, Bilder, HTML
  • Dateien bis zu 200 MB · Bilder bis zu 50 MB
  • PDFs mit bis zu 500 Seiten
  • API Zugang inklusive
Monatlich buchen

Pro beinhaltet auch das tägliche Gratisgeld. Die monatlichen Seiten werden jeden Monat zurückgesetzt und sammeln sich nicht an. Ausgaben werden 7 Tage lang aufbewahrt.

Vor Ort

Ihre Daten verlassen niemals Ihre Räumlichkeiten

Für Finanz-, Gesundheits-, Regierungs- und Forschungseinrichtungen wird PaddleOCR vollständig vor Ort bereitgestellt: Modelle und Daten laufen vollständig in Ihrem eigenen Netzwerk.

100%Daten bleiben lokal
KonformSicherheits-Framework bereit
24/7Dedizierter Support
Sprechen Sie mit uns über den Einsatz

Kundengeschichten

  • Ein erstklassiges WertpapierforschungsinstitutPrivates Parsing für eine interne Forschungswissensdatenbank – 50,000 Seiten pro Tag ohne Datenausgang.
  • Eine Forschungsabteilung eines TertiärkrankenhausesStrukturierte Extraktion aus medizinischer Literatur und Studienberichten, vollständig konform mit den Forschungsdatenregeln.
  • Eine Cloud der ProvinzregierungDigitalisierte Archive offizieller Dokumente für intelligente Suche und Fragen und Antworten.
Ein IT-Administrator und ein Forscher verwalten Dokumentdaten in einem lokalen Serverraum
Modelle und Daten bleiben in Ihrem eigenen Netzwerk und erfüllen Compliance-Anforderungen in den Bereichen Finanzen, Gesundheitswesen und Regierung.