PaddleOCR En línea · Sin instalación, abre y listo

Convierte cualquier documento
a Markdown

Desde PDF y documentos escaneados hasta Word, Excel y PowerPoint, PaddleOCR los lee todos y reconstruye títulos, párrafos, tablas, fórmulas y gráficos en su orden de lectura original. Genera Markdown y JSON con coordenadas, recupera las fórmulas como LaTeX y las estructuras moleculares como SMILES, y mantiene íntegras las tablas entre páginas y con celdas combinadas. Admite más de 100 idiomas y sus modelos se ejecutan en la nube, disponibles cuando los necesites. Con acceso a la API, puedes configurar un flujo de incorporación de documentos en solo un minuto.

Páginas analizadas diariamente
1.2M+
Páginas analizadas diariamente
Formatos admitidos
30+
Formatos de archivo y web
Tiempo de actividad del servicio
99.9%
Tiempo de actividad del servicio

PaddleOCR Espacio de trabajo

Cargar · analizar · exportar, todo en un solo lugar

PDF / DOCX / PPTX / XLSX / HTML / PNG

archivos de hasta 10 MB · imágenes de hasta 5 MB · PDF de hasta 5 páginas Actualiza a Pro

Solo para PDF. Activado: ignorar la capa de texto y usar OCR. Desactivado: detección automática. No afecta a otros formatos.
Formatos de exportación Markdown · JSON · HTML · DOCX · LaTeX

Lista de tareas

Inicia sesión para ver tus tareas

Tus documentos y resultados pertenecen a tu cuenta.

Iniciar sesión

Análisis en acción

Mira lo que sale de una página real

Al entregar el mismo documento, un OCR genérico le brinda una pared de texto. PaddleOCR mantiene la estructura, la química y las matemáticas.

Caso 01 · Estructuras químicas

Diagrama molecular → química computable y con capacidad de búsqueda

Las estructuras ya no se desechan como imágenes. PaddleOCR lee sistemas de anillos y sustituyentes, luego emite SMILES, fórmulas moleculares y LaTeX.

Página original PDF
Scheme 2. J. Med. Chem. 2026, 49, 1128 Fig. 2. Structure of paracetamol HO NHCOCH3
PaddleOCR salida
>
# structure → structured chemistry

{

  "type": "chemical_structure",

  "smiles": "CC(=O)Nc1ccc(O)cc1",

  "formula": "C8H9NO2",

  "iupac": "N-(4-hydroxyphenyl)acetamide",

  "latex": "\ce{CH3CONH-C6H4-OH}"

}


# inline Markdown output

Paracetamol ($C_8H_9NO_2$, SMILES: CC(=O)Nc1ccc(O)cc1)
OCR genéricoEl diagrama se elimina como una imagen; todo lo que sobrevive es "ver Fig. 2". Sin búsqueda, sin cálculo.
PaddleOCRRecuperado como SMILES / fórmula / LaTeX: listo para indexar, consultar y ejecutar cálculos de propiedades.
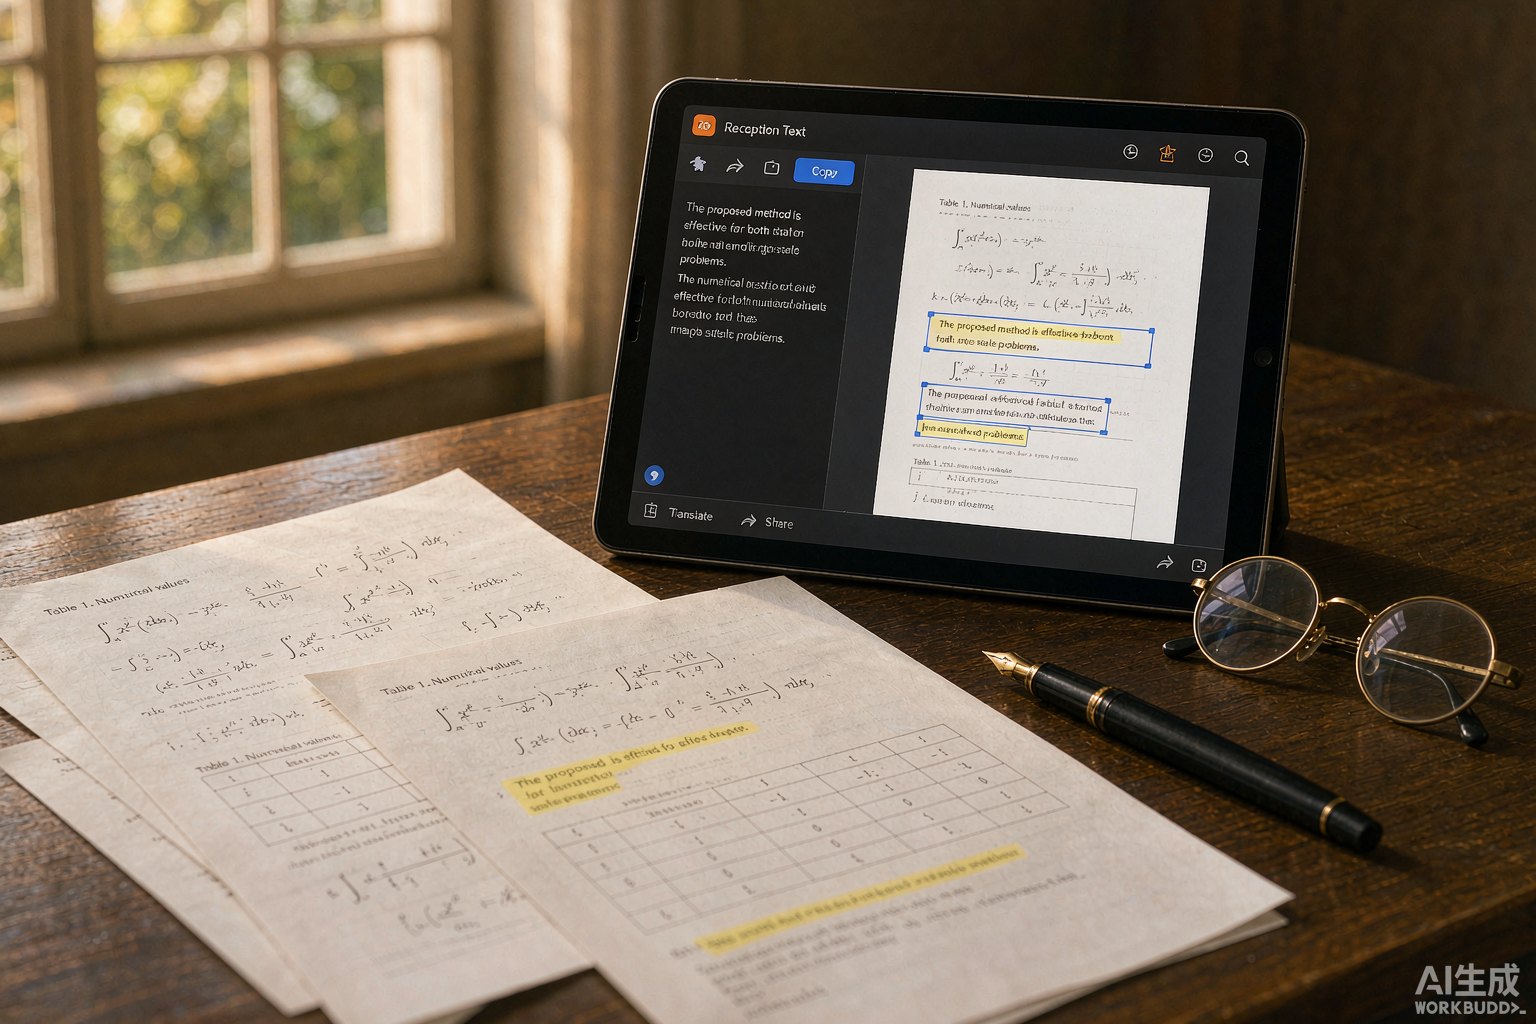
Caso 02 · Matemáticas

Fórmulas → limpiar LaTeX

Los subíndices, radicales, fracciones y letras griegas sobreviven intactos: el resultado se compila tal cual.

Página original PDF
PaddleOCR salida
>
# standard LaTeX, renders as-is

\int_{0}^{\infty} e^{-x^{2}}\,dx

= \frac{\sqrt{\pi}}{2}


\frac{\pi^{2}}{6}

= \sum_{n=1}^{N} \frac{1}{n^{2}}


# human-readable text kept too

∫₀^∞ e^(−x²) dx = √π / 2
Caso 03 · Tablas complejas

Encabezados combinados y tablas de extensión → filas estructuradas

Los encabezados y tablas de varios niveles que continúan a lo largo de las páginas se vuelven a unir, con las coordenadas de las celdas intactas.

Página original PDF
Table 3. Yield comparison, control vs. treatment Group Control Treatment Mean SD Mean SD Sample A 12.4 0.83 18.9 1.02 Sample B 14.1 0.91 21.3 1.14 Sample C 15.7 1.05 24.6 1.28 Sample D 17.2 1.11 26.8 1.35
PaddleOCR salida
>
# merged headers flattened to Markdown

| Group | Control mean | Control SD | Treatment mean | Treatment SD |

| --- | ---:| ---:| ---:| ---:|

| Sample A | 12.4 | 0.83 | 18.9 | 1.02 |

| Sample B | 14.1 | 0.91 | 21.3 | 1.14 |

| Sample C | 15.7 | 1.05 | 24.6 | 1.28 |

| Sample D | 17.2 | 1.11 | 26.8 | 1.35 |


# coordinates & merges kept in JSON

{"rows": 5, "cols": 5, "merged": [2, 2]}

Capacidades

Un motor de análisis creado para documentos complejos

Más allá de la extracción de texto. PaddleOCR comprende la estructura, la semántica y la jerarquía de los diseños científicos.

Química · matemáticas · tablas

01 / CIENCIA

Comprensión del diseño científico

Diseñado específicamente para fórmulas químicas, notación matemática, tablas complejas y diseños de varias columnas, preservando el orden de lectura y la estructura lógica.

Fórmulas químicasLaTeX matemáticasTablas de expansión
{ "type" : "title" , "level" : 1 "bbox" : [ 72, 96, 540 ], "text" : "3. Methods" }, "type" : "table" , "html" : "<table>…" }, …] Semántica · bbox · jerarquía

02 / AGENTES

Nativo de agentes de IA

JSON estructurado con etiquetas semánticas para títulos, párrafos, tablas, figuras y fórmulas: conéctese directamente a RAG, bases de conocimiento y flujos de trabajo de agentes.

Estructurado JSONRAG-listoEtiquetas semánticas
Layout 0.42s Formulas 0.61s Tables 0.77s 100 páginas · 1.8s en total

03 / VELOCIDAD

Computación elástica de alta velocidad

La programación elástica en la nube analiza documentos de cien páginas en segundos, mientras que los trabajos por lotes se ejecutan en paralelo para cumplir con el rendimiento empresarial.

Trabajos de menos de un segundoLotes paralelosEscalado elástico

¿Quién usa PaddleOCR?

Creado para equipos de investigación, ingeniería y negocios

Desde la lista de lectura de una persona hasta la base de conocimientos de toda la organización, PaddleOCR se encuentra en la primera puerta por donde los documentos ingresan a sus sistemas.

Un investigador científico que utiliza PaddleOCR en línea para analizar PDF artículos y literatura en texto estructurado

Investigadores

Investigadores científicos

Convierta artículos, patentes y notas de laboratorio en texto estructurado con capacidad de búsqueda en masa. Las fórmulas y la notación química sobreviven intactas, por lo que las revisiones bibliográficas dejan de ser transcripciones manuales.

Un desarrollador llama al documento PaddleOCR, analiza API y conecta los resultados a una aplicación.

Desarrolladores

Desarrolladores de aplicaciones de IA

Una línea de código. Obtenga la etiqueta semántica JSON directamente en su canalización, base de conocimientos o flujo de trabajo del agente RAG, sin necesidad de mantener un canal de análisis propio.

Un equipo revisa documentos analizando análisis y paneles en una gran pantalla de sala de reuniones

Empresa

Equipos empresariales e institucionales

Ingesta por lotes de informes de investigación, contratos y archivos. Combínelo con informes de uso e implementación local para que los activos de documentos realmente puedan buscarse.

API referencia

Integrar en una línea, llamarlo como una función local

Una RESTful API y SDKs cubren la carga, el estado y la descarga en varios idiomas, con códigos de error claros y webhooks para que la integración sea sencilla.

  • RESTful puntos finales con ejemplos cURL / Python / Node.js / Go
  • Elija respuestas síncronas o trabajos asíncronos
  • Códigos de error estructurados con guía de reintento
  • Devoluciones de llamada de webhook al finalizar, no es necesario realizar encuestas
Lea los documentos API completos
>
import requests

api = "https://api.example.com/api/open/v1"
headers = {"Authorization": "Bearer YOUR_API_KEY"}
with open("paper.pdf", "rb") as file:
    response = requests.post(api + "/tasks", headers=headers,
        files={"file": ("paper.pdf", file, "application/pdf")},
        data={"force_ocr": "true", "extra_formats": '["docx","html"]'})
response.raise_for_status()
body = response.json()
if body["code"] != 0: raise RuntimeError(body["msg"])
task = body["data"]
print(task["task_id"])
# GET /tasks/{id}; download results.full_zip_url when completed

Precios

Elija por uso, cambie en cualquier momento

Análisis en línea y los cinco formatos de exportación. Elija el plan que se ajuste a sus documentos.

Free

Regístrese y comience de inmediato

$0/ mes

No se requiere método de pago

  • 5 páginas gratis todos los días
  • PDF, Word, PPT, Excel, imágenes, HTML
  • Archivos hasta 10 MB · imágenes hasta 5 MB
  • PDF de hasta 5 páginas
  • Acceso web; API no está incluido
Empieza gratis

Pro · Mensual

Acceso flexible, un mes a la vez

$9.90/ mes

USD · pago único

  • 1,000 páginas cada mes
  • PDF, Word, PPT, Excel, imágenes, HTML
  • Archivos hasta 200 MB · imágenes hasta 50 MB
  • PDF de hasta 500 páginas
  • API acceso incluido
Elegir plan mensual

Pro también incluye la asignación diaria gratuita. Las páginas mensuales se reinician cada mes y no se acumulan. Los resultados se conservan durante 7 días.

En las instalaciones

Tus datos nunca salen de tus instalaciones

Para instituciones financieras, de atención médica, gubernamentales y de investigación, PaddleOCR se implementa completamente en las instalaciones: los modelos y los datos se ejecutan completamente dentro de su propia red.

100%Los datos permanecen locales
CumpleMarco de seguridad listo
24/7Soporte dedicado
Hable con nosotros sobre la implementación

Historias de clientes

  • Un instituto de investigación de valores de primer nivelAnálisis privado para una base de conocimientos de investigación interna: 50,000 páginas por día sin salida de datos.
  • Un departamento de investigación de un hospital terciarioExtracción estructurada de literatura médica e informes de ensayos, que cumple totalmente con las reglas de datos de investigación.
  • Una nube de gobierno provincialArchivos digitalizados de documentos oficiales que impulsan la búsqueda inteligente y las preguntas y respuestas.
Un administrador de TI y un investigador que administran datos de documentos en una sala de servidores local
Los modelos y los datos permanecen dentro de su propia red, cumpliendo con los requisitos de cumplimiento en finanzas, atención médica y gobierno.