PaddleOCR En ligne · Pas d'installation, ouvrez et c'est parti

Convertissez tout document
en Markdown

Des PDF et documents numérisés aux fichiers Word, Excel et PowerPoint, PaddleOCR les lit tous et restitue les titres, paragraphes, tableaux, formules et graphiques dans leur ordre de lecture initial. Il génère du Markdown et du JSON avec des coordonnées, restitue les formules en LaTeX et les structures moléculaires en SMILES, et préserve intégralement les tableaux sur plusieurs pages ainsi que les cellules fusionnées. Il prend en charge plus de 100 langues et ses modèles fonctionnent dans le cloud, disponibles à tout moment. Grâce à son API, une seule minute suffit pour mettre en place un pipeline d’intégration de documents.

Pages analysées quotidiennement
1.2M+
Pages analysées quotidiennement
Formats pris en charge
30+
Formats de fichiers et Web
Disponibilité du service
99.9%
Disponibilité du service

PaddleOCR Espace de travail

Télécharger · analyser · exporter, le tout en un seul endroit

PDF / DOCX / PPTX / XLSX / HTML / PNG

fichiers jusqu'à 10 MB · images jusqu'à 5 MB · PDF jusqu'à 5 pages Mise à niveau vers Pro

PDF uniquement. Activé : ignorer la couche de texte et utiliser l’OCR. Désactivé : détection automatique. Les autres formats ne sont pas affectés.
Formats d'exportation Markdown · JSON · HTML · DOCX · LaTeX

Liste des tâches

Connectez-vous pour voir vos tâches

Vos documents et résultats appartiennent à votre compte.

Se connecter

L'analyse en action

Voir ce qui revient d'une vraie page

Remis au même document, une OCR générique vous donne un mur de texte. PaddleOCR conserve la structure, la chimie et les mathématiques.

Cas 01 · Structures chimiques

Diagramme moléculaire → chimie consultable et calculable

Les structures ne sont plus jetées comme des images. PaddleOCR lit les systèmes cycliques et les substituants, puis émet SMILES, les formules moléculaires et LaTeX.

Page originale PDF
Scheme 2. J. Med. Chem. 2026, 49, 1128 Fig. 2. Structure of paracetamol HO NHCOCH3
Sortie PaddleOCR
>
# structure → structured chemistry

{

  "type": "chemical_structure",

  "smiles": "CC(=O)Nc1ccc(O)cc1",

  "formula": "C8H9NO2",

  "iupac": "N-(4-hydroxyphenyl)acetamide",

  "latex": "\ce{CH3CONH-C6H4-OH}"

}


# inline Markdown output

Paracetamol ($C_8H_9NO_2$, SMILES: CC(=O)Nc1ccc(O)cc1)
OCR génériqueLe diagramme est supprimé sous forme d'image — tout ce qui survit est "voir Fig. 2". Pas de recherche, pas de calcul.
PaddleOCRRécupéré sous le nom SMILES / formula / LaTeX — prêt à indexer, interroger et exécuter des calculs de propriétés.
Cas 02 · Mathématiques

Formules → nettoyer LaTeX

Les indices, radicaux, fractions et lettres grecques survivent intacts — la sortie est compilée telle quelle.

Page originale PDF
Sortie PaddleOCR
>
# standard LaTeX, renders as-is

\int_{0}^{\infty} e^{-x^{2}}\,dx

= \frac{\sqrt{\pi}}{2}


\frac{\pi^{2}}{6}

= \sum_{n=1}^{N} \frac{1}{n^{2}}


# human-readable text kept too

∫₀^∞ e^(−x²) dx = √π / 2
Cas 03 · Tables complexes

En-têtes fusionnés et tables étendues → lignes structurées

Les en-têtes et les tableaux à plusieurs niveaux qui se poursuivent sur les pages sont recousus, avec les coordonnées des cellules intactes.

Page originale PDF
Table 3. Yield comparison, control vs. treatment Group Control Treatment Mean SD Mean SD Sample A 12.4 0.83 18.9 1.02 Sample B 14.1 0.91 21.3 1.14 Sample C 15.7 1.05 24.6 1.28 Sample D 17.2 1.11 26.8 1.35
Sortie PaddleOCR
>
# merged headers flattened to Markdown

| Group | Control mean | Control SD | Treatment mean | Treatment SD |

| --- | ---:| ---:| ---:| ---:|

| Sample A | 12.4 | 0.83 | 18.9 | 1.02 |

| Sample B | 14.1 | 0.91 | 21.3 | 1.14 |

| Sample C | 15.7 | 1.05 | 24.6 | 1.28 |

| Sample D | 17.2 | 1.11 | 26.8 | 1.35 |


# coordinates & merges kept in JSON

{"rows": 5, "cols": 5, "merged": [2, 2]}

Capacités

Un moteur d'analyse conçu pour les documents complexes

Au-delà de l'extraction de texte. PaddleOCR comprend la structure, la sémantique et la hiérarchie des présentations scientifiques.

Chimie · mathématiques · tableaux

01 / SCIENCES

Compréhension de la disposition scientifique

Spécialement conçu pour les formules chimiques, la notation mathématique, les tableaux complexes et les dispositions à plusieurs colonnes, en préservant l'ordre de lecture et la structure logique.

Formules chimiquesLaTeX mathématiquesTables étendues
{ "type" : "title" , "level" : 1 "bbox" : [ 72, 96, 540 ], "text" : "3. Methods" }, "type" : "table" , "html" : "<table>…" }, …] Sémantique · bbox · hiérarchie

02 / AGENTS

Natif pour les agents IA

JSON structuré avec des balises sémantiques pour les titres, les paragraphes, les tableaux, les figures et les formules — connectez-vous directement à RAG, aux bases de connaissances et aux flux de travail des agents.

Structuré JSONRAG-prêtBalises sémantiques
Layout 0.42s Formulas 0.61s Tables 0.77s 100 pages · 1.8s au total

03 / VITESSE

Calcul élastique à grande vitesse

La planification cloud élastique analyse des documents d'une centaine de pages en quelques secondes, tandis que les tâches par lots s'exécutent en parallèle pour répondre au débit de l'entreprise.

Emplois inférieurs à la secondeLots parallèlesMise à l'échelle élastique

Qui utilise PaddleOCR

Conçu pour les équipes de recherche, d'ingénierie et commerciales

De la liste de lecture d'une personne à une base de connaissances à l'échelle de l'organisation, PaddleOCR se situe à la première porte où les documents entrent dans vos systèmes.

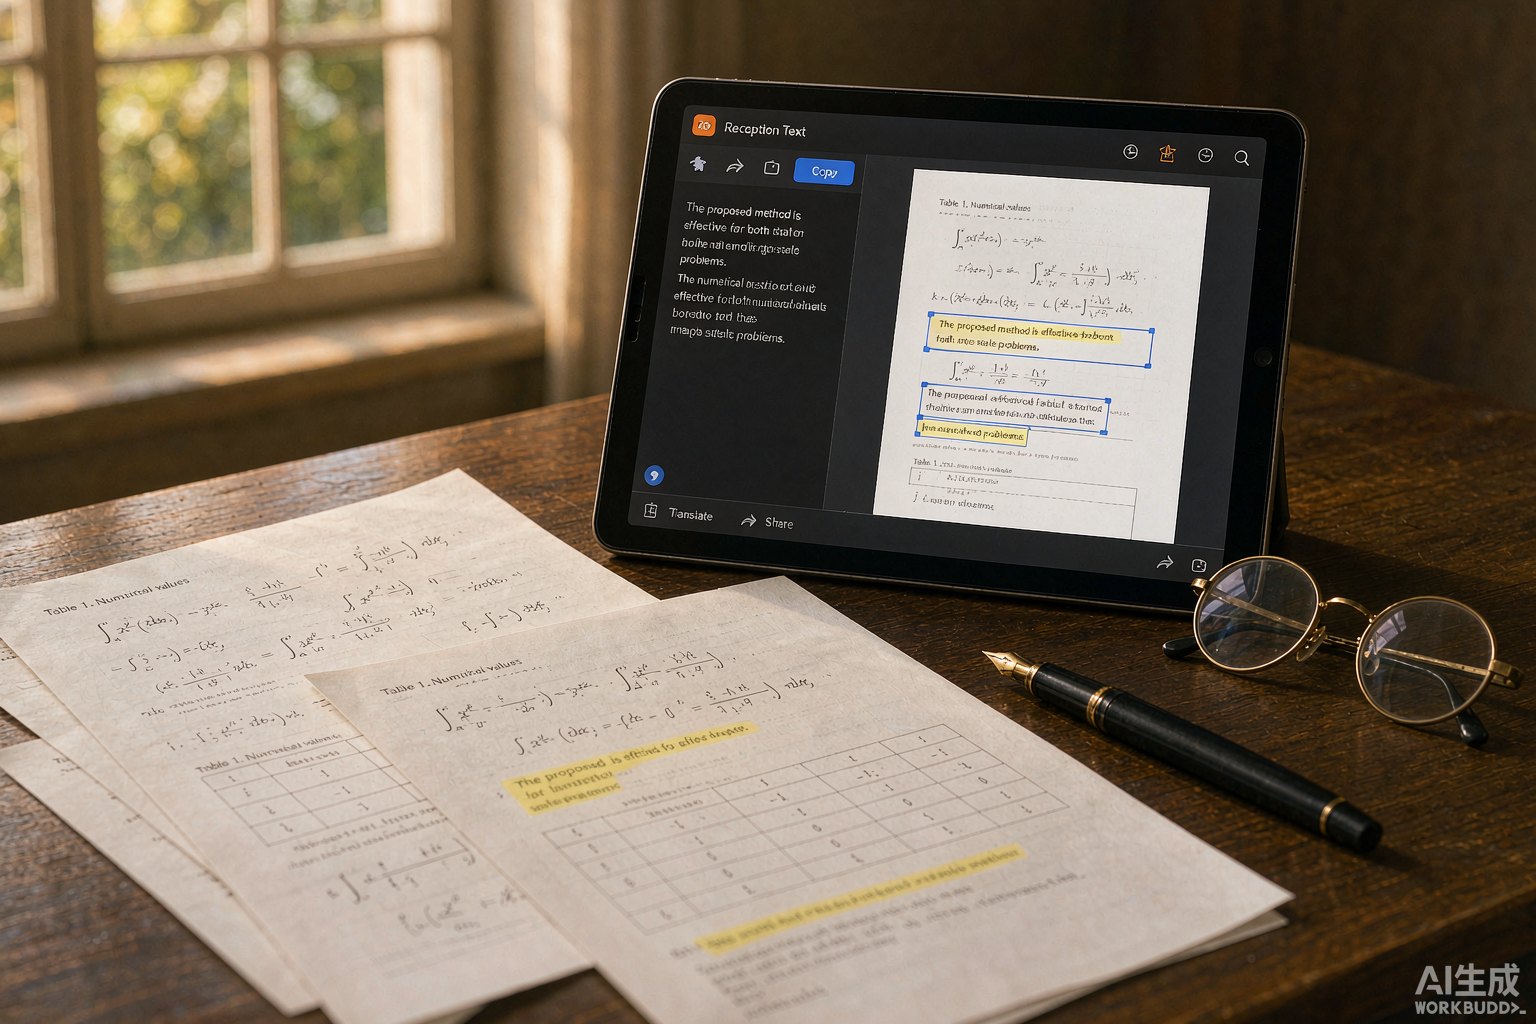
Un chercheur scientifique utilisant PaddleOCR en ligne pour analyser PDF articles et littérature en texte structuré

Chercheurs

Chercheurs scientifiques

Transformez des articles, des brevets et des notes de laboratoire en texte structuré consultable en masse. Les formules et la notation chimique survivent intactes, de sorte que les revues de littérature cessent d'être une transcription manuelle.

Un développeur appelant le document PaddleOCR analysant API et câblant les résultats dans une application

Développeurs

Développeurs d'applications IA

Une ligne de code. Obtenez le balisage sémantique JSON directement dans votre pipeline RAG, votre base de connaissances ou votre flux de travail d'agent - aucun pipeline d'analyse à maintenir.

Une équipe examinant les analyses d'analyse de documents et les tableaux de bord sur un grand écran de salle de réunion

Entreprise

Équipes entreprises et institutionnelles

Ingérez par lots des rapports de recherche, des contrats et des archives. Associez-le à un déploiement sur site et à des rapports d'utilisation pour rendre les ressources documentaires véritablement consultables.

Référence API

Intégrez sur une seule ligne, appelez-la comme une fonction locale

Un RESTful API et un SDKs multilingue couvrent le téléchargement, l'état et le téléchargement — avec des codes d'erreur et des webhooks clairs pour que l'intégration reste simple.

  • Points de terminaison RESTful avec exemples cURL / Python / Node.js / Go
  • Choisissez des réponses synchrones ou des tâches asynchrones
  • Codes d'erreur structurés avec instructions de nouvelle tentative
  • Rappels du Webhook à la fin, aucune interrogation nécessaire
Lire la documentation complète API
>
import requests

api = "https://api.example.com/api/open/v1"
headers = {"Authorization": "Bearer YOUR_API_KEY"}
with open("paper.pdf", "rb") as file:
    response = requests.post(api + "/tasks", headers=headers,
        files={"file": ("paper.pdf", file, "application/pdf")},
        data={"force_ocr": "true", "extra_formats": '["docx","html"]'})
response.raise_for_status()
body = response.json()
if body["code"] != 0: raise RuntimeError(body["msg"])
task = body["data"]
print(task["task_id"])
# GET /tasks/{id}; download results.full_zip_url when completed

Tarifs

Choisissez par utilisation, changez à tout moment

Analyse en ligne et les cinq formats d'exportation. Choisissez le plan qui correspond à vos documents.

Free

Inscrivez-vous et commencez tout de suite

$0/ mois

Aucun mode de paiement requis

  • 5 pages gratuites chaque jour
  • PDF, Word, PPT, Excel, images, HTML
  • Fichiers jusqu'à 10 MB · images jusqu'à 5 MB
  • PDF jusqu'à 5 pages
  • Accès Internet ; API n'est pas inclus
Démarrez gratuitement

Pro · Mensuel

Accès flexible, un mois à la fois

$9.90/ mois

USD · paiement unique

  • 1,000 pages chaque mois
  • PDF, Word, PPT, Excel, images, HTML
  • Fichiers jusqu'à 200 MB · images jusqu'à 50 MB
  • PDF jusqu'à 500 pages
  • API accès inclus
Choisir le forfait mensuel

Pro inclut également l'indemnité journalière gratuite. Les pages mensuelles sont réinitialisées chaque mois et ne s'accumulent pas. Les sorties sont conservées pendant 7 jours.

Sur site

Vos données ne quittent jamais vos locaux

Pour les institutions financières, de santé, gouvernementales et de recherche, PaddleOCR se déploie entièrement sur site : les modèles et les données s'exécutent entièrement au sein de votre propre réseau.

100%Les données restent locales
ConformeCadre de sécurité prêt
24/7Support dédié
Parlez-nous du déploiement

Témoignages clients

  • Un institut de recherche en valeurs mobilières de premier planAnalyse privée pour une base de connaissances de recherche interne — 50,000 pages par jour sans sortie de données.
  • Un service de recherche hospitalier tertiaireExtraction structurée de la littérature médicale et des rapports d'essais, entièrement conforme aux règles des données de recherche.
  • Un cloud du gouvernement provincialArchives numérisées de documents officiels permettant une recherche intelligente et des questions-réponses.
Un administrateur informatique et un chercheur gérant les données documentaires dans une salle de serveurs sur site
Les modèles et les données restent dans votre propre réseau, répondant ainsi aux exigences de conformité dans les domaines de la finance, de la santé et du gouvernement.