PaddleOCR Online · Nessuna installazione, apri e vai

Converti qualsiasi documento
in Markdown

Dai PDF e dalle scansioni a Word, Excel e PowerPoint, PaddleOCR legge tutti questi formati e ricostruisce titoli, paragrafi, tabelle, formule e grafici nel loro ordine di lettura originale. Genera Markdown e JSON con coordinate, recupera le formule come LaTeX e le strutture molecolari come SMILES, e mantiene intatte le tabelle tra pagine diverse e con celle unite. Supporta oltre 100 lingue e i modelli vengono eseguiti nel cloud, disponibili ogni volta che servono. Con l’accesso API, basta un minuto per configurare una pipeline di acquisizione dei documenti.

Pagine analizzate quotidianamente
1.2M+
Pagine analizzate quotidianamente
Formati supportati
30+
Formati file e web
Tempo di attività del servizio
99.9%
Tempo di attività del servizio

PaddleOCR Area di lavoro

Carica · analizza · esporta, tutto in un unico posto

PDF / DOCX / PPTX / XLSX / HTML / PNG

file fino a 10 MB · immagini fino a 5 MB · PDF fino a 5 pagine Aggiorna a Pro

Solo per PDF. Attivo: ignora il livello di testo e usa OCR. Disattivo: rilevamento automatico. Gli altri formati restano invariati.
Formati di esportazione Markdown · JSON · HTML · DOCX · LaTeX

Elenco attività

Accedi per vedere le tue attività

I tuoi documenti e risultati appartengono al tuo account.

Accedi

Analisi in azione

Guarda cosa ritorna da una pagina reale

Consegnato lo stesso documento, un OCR generico ti restituisce un muro di testo. PaddleOCR mantiene la struttura, la chimica e la matematica.

Caso 01 · Strutture chimiche

Diagramma molecolare → chimica ricercabile e computabile

Le strutture non vengono più gettate via come immagini. PaddleOCR legge i sistemi di anelli e i sostituenti, quindi emette SMILES, formule molecolari e LaTeX.

Pagina originale PDF
Scheme 2. J. Med. Chem. 2026, 49, 1128 Fig. 2. Structure of paracetamol HO NHCOCH3
PaddleOCR uscita
>
# structure → structured chemistry

{

  "type": "chemical_structure",

  "smiles": "CC(=O)Nc1ccc(O)cc1",

  "formula": "C8H9NO2",

  "iupac": "N-(4-hydroxyphenyl)acetamide",

  "latex": "\ce{CH3CONH-C6H4-OH}"

}


# inline Markdown output

Paracetamol ($C_8H_9NO_2$, SMILES: CC(=O)Nc1ccc(O)cc1)
OCR genericoIl diagramma viene eliminato come immagine: tutto ciò che sopravvive è "vedi Fig. 2". Nessuna ricerca, nessun calcolo.
PaddleOCRRecuperato come SMILES / formula / LaTeX: pronto per indicizzare, eseguire query ed eseguire calcoli sulle proprietà.
Caso 02 · Matematica

Formule → pulisci LaTeX

Pedici, radicali, frazioni e lettere greche sopravvivono intatti: l'output viene compilato così com'è.

Pagina originale PDF
PaddleOCR uscita
>
# standard LaTeX, renders as-is

\int_{0}^{\infty} e^{-x^{2}}\,dx

= \frac{\sqrt{\pi}}{2}


\frac{\pi^{2}}{6}

= \sum_{n=1}^{N} \frac{1}{n^{2}}


# human-readable text kept too

∫₀^∞ e^(−x²) dx = √π / 2
Caso 03 · Tabelle complesse

Intestazioni unite e tabelle estese → righe strutturate

Le intestazioni e le tabelle multilivello che continuano attraverso le pagine vengono ricucite insieme, con le coordinate delle celle intatte.

Pagina originale PDF
Table 3. Yield comparison, control vs. treatment Group Control Treatment Mean SD Mean SD Sample A 12.4 0.83 18.9 1.02 Sample B 14.1 0.91 21.3 1.14 Sample C 15.7 1.05 24.6 1.28 Sample D 17.2 1.11 26.8 1.35
PaddleOCR uscita
>
# merged headers flattened to Markdown

| Group | Control mean | Control SD | Treatment mean | Treatment SD |

| --- | ---:| ---:| ---:| ---:|

| Sample A | 12.4 | 0.83 | 18.9 | 1.02 |

| Sample B | 14.1 | 0.91 | 21.3 | 1.14 |

| Sample C | 15.7 | 1.05 | 24.6 | 1.28 |

| Sample D | 17.2 | 1.11 | 26.8 | 1.35 |


# coordinates & merges kept in JSON

{"rows": 5, "cols": 5, "merged": [2, 2]}

Capacità

Un motore di analisi creato per documenti complessi

Oltre l'estrazione del testo. PaddleOCR comprende la struttura, la semantica e la gerarchia dei layout scientifici.

Chimica · matematica · tabelle

01 / SCIENZA

Comprensione del layout scientifico

Progettato appositamente per formule chimiche, notazione matematica, tabelle complesse e layout a più colonne, preservando l'ordine di lettura e la struttura logica.

Formule chimicheLaTeX matematicaTabelle di estensione
{ "type" : "title" , "level" : 1 "bbox" : [ 72, 96, 540 ], "text" : "3. Methods" }, "type" : "table" , "html" : "<table>…" }, …] Semantica · bbox · gerarchia

02 /AGENTI

Nativo degli agenti AI

JSON strutturato con tag semantici per intestazioni, paragrafi, tabelle, figure e formule: collegalo direttamente a RAG, basi di conoscenza e flussi di lavoro degli agenti.

Strutturato JSONRAG-prontoTag semantici
Layout 0.42s Formulas 0.61s Tables 0.77s 100 pagine · 1.8s totale

03 / VELOCITÀ

Calcolo elastico ad alta velocità

La pianificazione cloud elastica analizza documenti da centinaia di pagine in pochi secondi, mentre i processi batch vengono eseguiti in parallelo per soddisfare la produttività aziendale.

Lavori inferiori al secondoLotti paralleliScalatura elastica

Chi utilizza PaddleOCR

Costruito per team di ricerca, ingegneria e affari

Dall'elenco di lettura di una persona a una base di conoscenza a livello di organizzazione, PaddleOCR si trova al primo cancello in cui i documenti entrano nei tuoi sistemi.

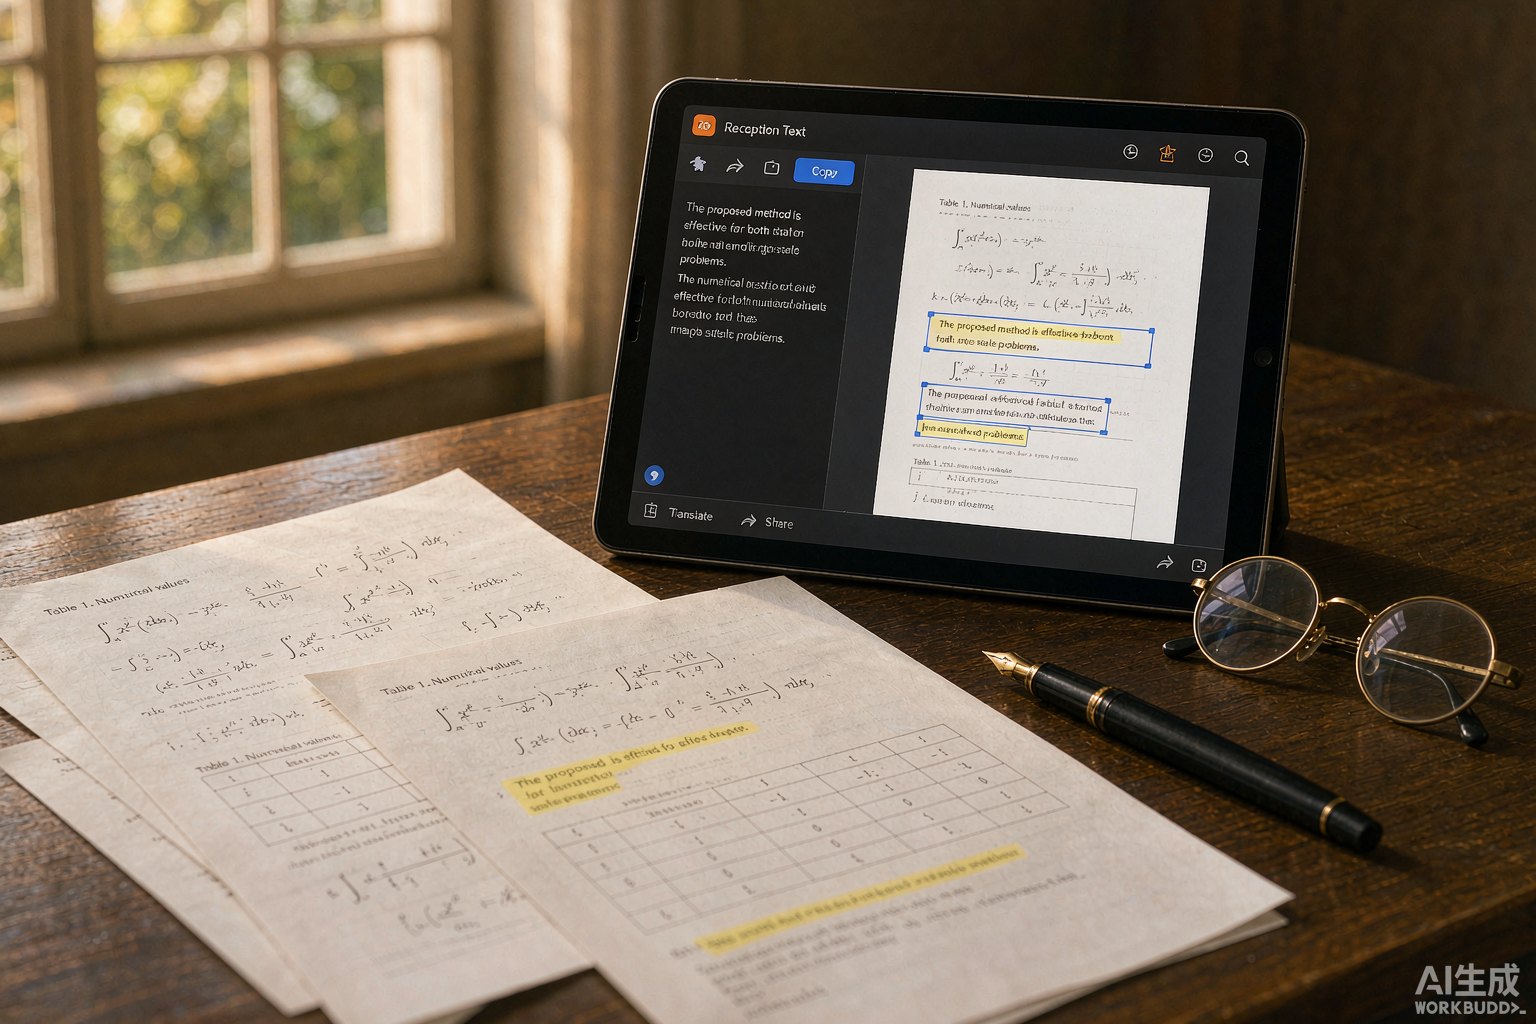
Un ricercatore scientifico che utilizza PaddleOCR online per analizzare documenti e letteratura PDF in testo strutturato

Ricercatori

Ricercatori scientifici

Trasforma documenti, brevetti e appunti di laboratorio in testo strutturato ricercabile in blocco. Le formule e la notazione chimica sopravvivono intatte, quindi le revisioni della letteratura smettono di essere trascrizioni manuali.

Uno sviluppatore chiama il documento PaddleOCR analizzando API e collega i risultati a un'applicazione

Sviluppatori

Sviluppatori di applicazioni AI

Una riga di codice. Ottieni JSON taggato semanticamente direttamente nella tua pipeline RAG, nella knowledge base o nel flusso di lavoro dell'agente, senza alcuna pipeline di analisi da mantenere.

Un team che esamina un documento analizzando analisi e dashboard sullo schermo di una sala riunioni di grandi dimensioni

Impresa

Team aziendali e istituzionali

Acquisisci in batch rapporti di ricerca, contratti e archivi. Abbinalo alla distribuzione in sede e al reporting sull'utilizzo per rendere le risorse dei documenti realmente ricercabili.

API riferimento

Integra in una riga, chiamala come una funzione locale

RESTful API e SDKs multilingue coprono caricamento, stato e download, con codici di errore e webhook chiari, così l'integrazione rimane semplice.

  • RESTful endpoint con cURL / Python / Node.js / Go esempi
  • Scegli risposte sincrone o lavori asincroni
  • Codici di errore strutturati con guida ai tentativi
  • Callback webhook al completamento, nessun polling necessario
Leggi la documentazione completa API
>
import requests

api = "https://api.example.com/api/open/v1"
headers = {"Authorization": "Bearer YOUR_API_KEY"}
with open("paper.pdf", "rb") as file:
    response = requests.post(api + "/tasks", headers=headers,
        files={"file": ("paper.pdf", file, "application/pdf")},
        data={"force_ocr": "true", "extra_formats": '["docx","html"]'})
response.raise_for_status()
body = response.json()
if body["code"] != 0: raise RuntimeError(body["msg"])
task = body["data"]
print(task["task_id"])
# GET /tasks/{id}; download results.full_zip_url when completed

Prezzi

Scegli in base all'utilizzo, cambia in qualsiasi momento

Analisi online e tutti e cinque i formati di esportazione. Scegli il piano adatto ai tuoi documenti.

Free

Iscriviti e inizia subito

$0/mese

Nessun metodo di pagamento richiesto

  • 5 pagine libere ogni giorno
  • PDF, Word, PPT, Excel, immagini, HTML
  • File fino a 10 MB · immagini fino a 5 MB
  • PDF fino a 5 pagine
  • Accesso web; API non è incluso
Inizia gratis

Pro · Mensile

Accesso flessibile, un mese alla volta

$9.90/mese

USD · pagamento una tantum

  • 1,000 pagine ogni mese
  • PDF, Word, PPT, Excel, immagini, HTML
  • File fino a 200 MB · immagini fino a 50 MB
  • PDF fino a 500 pagine
  • API accesso incluso
Scegli il piano mensile

Pro comprende anche la gratuità giornaliera. Le pagine mensili vengono reimpostate ogni mese e non si accumulano. Gli output vengono conservati per 7 giorni.

In sede

I tuoi dati non escono mai dalla tua sede

Per istituti finanziari, sanitari, governativi e di ricerca, PaddleOCR viene distribuito completamente in sede: modelli e dati vengono eseguiti interamente all'interno della tua rete.

100%I dati rimangono locali
ConformeQuadro di sicurezza pronto
24/7Assistenza dedicata
Parlaci della distribuzione

Storie di clienti

  • Un istituto di ricerca sui titoli di alto livelloAnalisi privata per una knowledge base di ricerca interna: 50,000 pagine al giorno con zero dati in uscita.
  • Un dipartimento di ricerca ospedaliero terziarioEstrazione strutturata dalla letteratura medica e dai rapporti di sperimentazione, pienamente conforme alle regole dei dati di ricerca.
  • Una nuvola del governo provincialeArchivi digitalizzati di documenti ufficiali che alimentano la ricerca intelligente e le domande e risposte.
Un amministratore IT e un ricercatore che gestiscono i dati dei documenti in una sala server locale
Modelli e dati rimangono all'interno della tua rete, soddisfacendo i requisiti di conformità in ambito finanziario, sanitario e governativo.