PaddleOCR Online · Geen installatie, openen en klaar

Zet elk document om
naar Markdown

Van PDF’s en scans tot Word, Excel en PowerPoint: PaddleOCR leest al deze formaten en herstelt koppen, alinea’s, tabellen, formules en grafieken in de oorspronkelijke leesvolgorde. Het levert Markdown en JSON met coördinaten, herstelt formules als LaTeX en molecuulstructuren als SMILES, en houdt tabellen intact over pagina-einden heen en bij samengevoegde cellen. Het ondersteunt meer dan 100 talen en de modellen draaien in de cloud, klaar om op elk moment aan te roepen. Met API-toegang zet je in slechts één minuut een pipeline voor documentinvoer op.

Pagina's worden dagelijks geparseerd
1.2M+
Pagina's worden dagelijks geparseerd
Ondersteunde formaten
30+
Bestands- en webformaten
Service-uptime
99.9%
Service-uptime

PaddleOCR Werkruimte

Uploaden · parseren · exporteren, alles op één plek

PDF / DOCX / PPTX / XLSX / HTML / PNG

bestanden tot 10 MB · afbeeldingen tot 5 MB · PDF's tot 5 pagina's Upgrade naar Pro

Alleen voor PDF. Aan: negeer de bestaande tekstlaag en gebruik OCR. Uit: automatisch detecteren. Andere formaten blijven ongewijzigd.
Exportformaten Markdown · JSON · HTML · DOCX · LaTeX

Takenlijst

Meld u aan om uw taken te bekijken

Uw documenten en resultaten horen bij uw account.

Aanmelden

Parseren in actie

Kijk wat er terugkomt van een echte pagina

Als u hetzelfde document overhandigt, geeft een generieke OCR u een muur van tekst. PaddleOCR behoudt de structuur, de chemie en de wiskunde.

Geval 01 · Chemische structuren

Moleculair diagram → doorzoekbare, berekenbare chemie

Structuren worden niet langer als afbeeldingen weggegooid. PaddleOCR leest ringsystemen en substituenten en zendt vervolgens SMILES, molecuulformules en LaTeX uit.

Originele PDF pagina
Scheme 2. J. Med. Chem. 2026, 49, 1128 Fig. 2. Structure of paracetamol HO NHCOCH3
PaddleOCR uitvoer
>
# structure → structured chemistry

{

  "type": "chemical_structure",

  "smiles": "CC(=O)Nc1ccc(O)cc1",

  "formula": "C8H9NO2",

  "iupac": "N-(4-hydroxyphenyl)acetamide",

  "latex": "\ce{CH3CONH-C6H4-OH}"

}


# inline Markdown output

Paracetamol ($C_8H_9NO_2$, SMILES: CC(=O)Nc1ccc(O)cc1)
Algemene OCRHet diagram wordt als afbeelding weggelaten. Het enige dat overblijft is "zie Fig. 2". Geen zoeken, geen berekening.
PaddleOCRHersteld als SMILES / formule / LaTeX — gereed voor het indexeren, opvragen en uitvoeren van eigenschapsberekeningen.
Zaak 02 · Wiskunde

Formules → opschonen LaTeX

Subscripts, radicalen, breuken en Griekse letters blijven intact: de uitvoer wordt gecompileerd zoals hij is.

Originele PDF pagina
PaddleOCR uitvoer
>
# standard LaTeX, renders as-is

\int_{0}^{\infty} e^{-x^{2}}\,dx

= \frac{\sqrt{\pi}}{2}


\frac{\pi^{2}}{6}

= \sum_{n=1}^{N} \frac{1}{n^{2}}


# human-readable text kept too

∫₀^∞ e^(−x²) dx = √π / 2
Case 03 · Complexe tabellen

Samengevoegde kopteksten en overspannende tabellen → gestructureerde rijen

Kopteksten en tabellen met meerdere niveaus die doorlopen over pagina's worden weer aan elkaar geplakt, waarbij de celcoördinaten intact blijven.

Originele PDF pagina
Table 3. Yield comparison, control vs. treatment Group Control Treatment Mean SD Mean SD Sample A 12.4 0.83 18.9 1.02 Sample B 14.1 0.91 21.3 1.14 Sample C 15.7 1.05 24.6 1.28 Sample D 17.2 1.11 26.8 1.35
PaddleOCR uitvoer
>
# merged headers flattened to Markdown

| Group | Control mean | Control SD | Treatment mean | Treatment SD |

| --- | ---:| ---:| ---:| ---:|

| Sample A | 12.4 | 0.83 | 18.9 | 1.02 |

| Sample B | 14.1 | 0.91 | 21.3 | 1.14 |

| Sample C | 15.7 | 1.05 | 24.6 | 1.28 |

| Sample D | 17.2 | 1.11 | 26.8 | 1.35 |


# coordinates & merges kept in JSON

{"rows": 5, "cols": 5, "merged": [2, 2]}

Mogelijkheden

Een parseerengine gebouwd voor complexe documenten

Verder dan tekstextractie. PaddleOCR begrijpt de structuur, semantiek en hiërarchie van wetenschappelijke lay-outs.

Scheikunde · wiskunde · tabellen

01 / WETENSCHAP

Begrip van wetenschappelijke lay-out

Speciaal ontwikkeld voor chemische formules, wiskundige notaties, complexe tabellen en lay-outs met meerdere kolommen, waarbij de leesvolgorde en logische structuur behouden blijven.

Chemische formulesLaTeX wiskundeTafels overspannen
{ "type" : "title" , "level" : 1 "bbox" : [ 72, 96, 540 ], "text" : "3. Methods" }, "type" : "table" , "html" : "<table>…" }, …] Semantiek · bbox · hiërarchie

02 / AGENTEN

Oorspronkelijk voor AI-agenten

Gestructureerd JSON met semantische tags voor koppen, alinea's, tabellen, figuren en formules — rechtstreeks aan te sluiten op RAG, kennisbanken en agentworkflows.

Gestructureerd JSONRAG gereedSemantische tags
Layout 0.42s Formulas 0.61s Tables 0.77s 100 pagina's · 1.8s totaal

03 / SNELHEID

Elastisch rekenwerk met hoge snelheid

Dankzij de elastische cloudplanning worden documenten van honderd pagina's binnen enkele seconden geparseerd, terwijl batchtaken parallel worden uitgevoerd om aan de bedrijfsdoorvoer te voldoen.

Taken van minder dan een secondeParallelle batchesElastisch schalen

Wie gebruikt PaddleOCR

Gebouwd voor onderzoeks-, engineering- en zakelijke teams

Van de leeslijst van één persoon tot een kennisbank voor de hele organisatie: PaddleOCR staat aan de eerste poort waar documenten uw systemen binnenkomen.

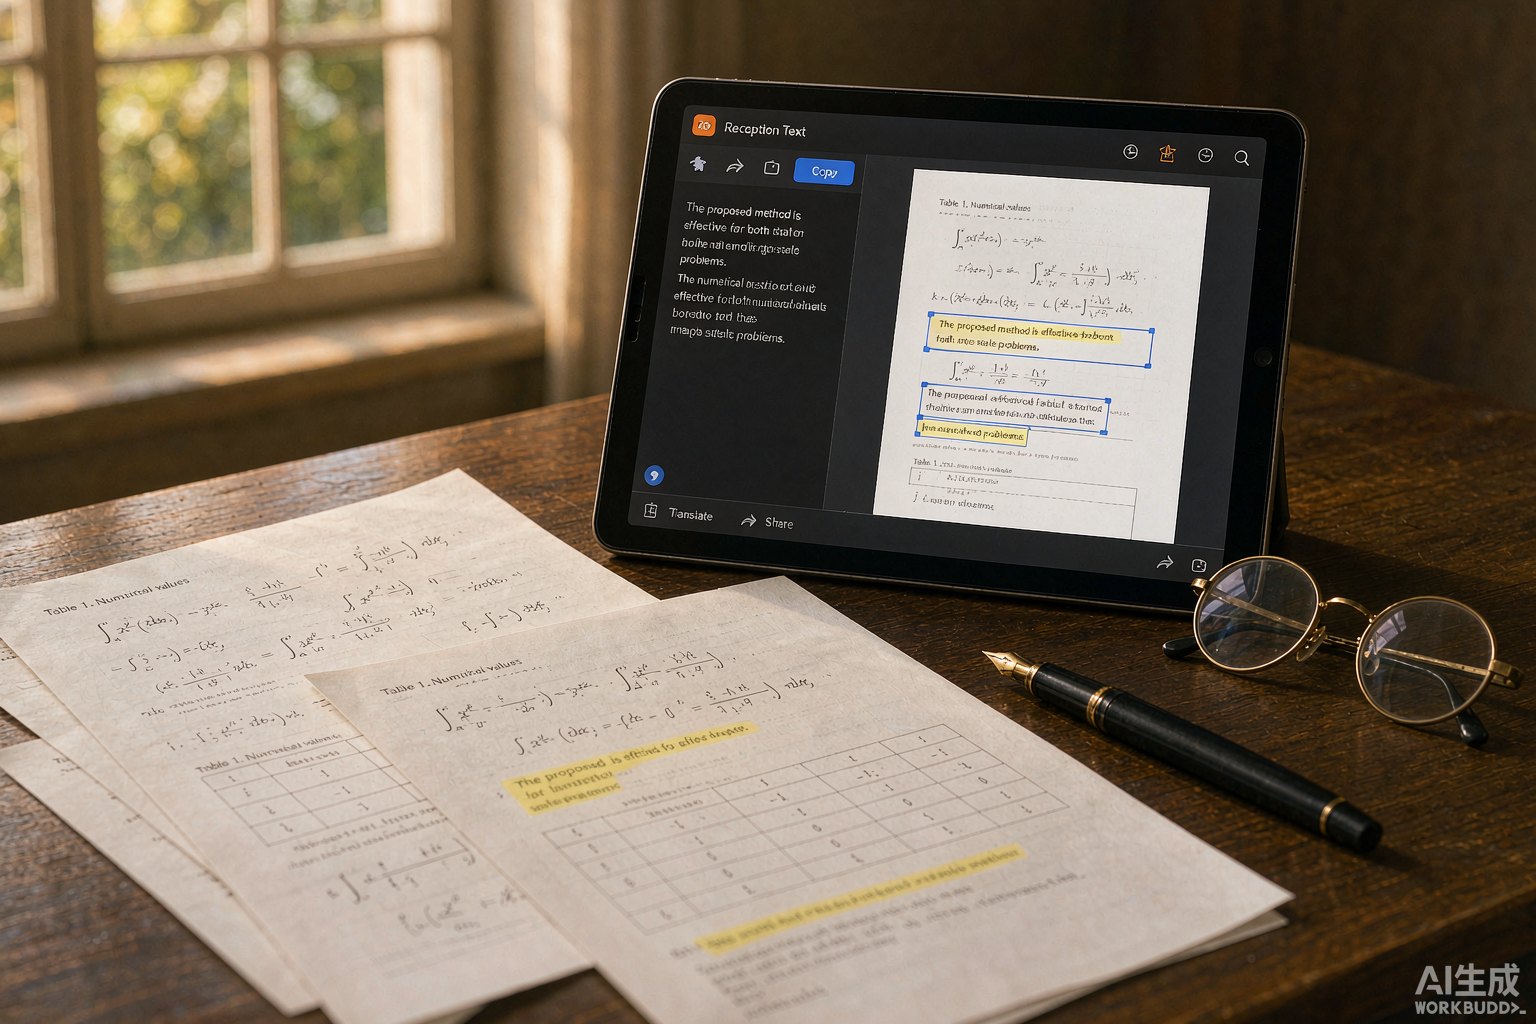
Een wetenschappelijk onderzoeker die PaddleOCR online gebruikt om PDF artikelen en literatuur te ontleden in gestructureerde tekst

Onderzoekers

Wetenschappelijke onderzoekers

Zet papieren, patenten en laboratoriumaantekeningen in bulk om in doorzoekbare gestructureerde tekst. Formules en chemische notaties blijven intact, dus literatuuroverzichten zijn niet langer handmatige transcripties.

Een ontwikkelaar die het PaddleOCR-document aanroept, API parseert en de resultaten in een applicatie aansluit

Ontwikkelaars

Ontwikkelaars van AI-applicaties

Eén regel code. Zorg dat u semantisch getagd wordt met JSON, rechtstreeks in uw RAG-pijplijn, kennisbank of agentworkflow; u hoeft zelf geen parseerpijplijn te onderhouden.

Een team dat documenten beoordeelt en analyses en dashboards parseert op een groot scherm in een vergaderruimte

Onderneming

Bedrijfs- en institutionele teams

In batches opgenomen onderzoeksrapporten, contracten en archieven. Combineer het met on-premise implementatie en gebruiksrapportage om documentmiddelen echt doorzoekbaar te maken.

API referentie

Integreer in één regel, noem het als een lokale functie

Een RESTful API en meertalige SDKs omvatten upload, status en download — met duidelijke foutcodes en webhooks zodat de integratie probleemloos blijft.

  • RESTful eindpunten met cURL / Python / Node.js / Go voorbeelden
  • Kies synchrone antwoorden of asynchrone taken
  • Gestructureerde foutcodes met begeleiding voor opnieuw proberen
  • Webhook-callbacks na voltooiing, geen polling nodig
Lees de volledige API documenten
>
import requests

api = "https://api.example.com/api/open/v1"
headers = {"Authorization": "Bearer YOUR_API_KEY"}
with open("paper.pdf", "rb") as file:
    response = requests.post(api + "/tasks", headers=headers,
        files={"file": ("paper.pdf", file, "application/pdf")},
        data={"force_ocr": "true", "extra_formats": '["docx","html"]'})
response.raise_for_status()
body = response.json()
if body["code"] != 0: raise RuntimeError(body["msg"])
task = body["data"]
print(task["task_id"])
# GET /tasks/{id}; download results.full_zip_url when completed

Prijzen

Kies op gebruik, schakel op elk gewenst moment

Online parseren en alle vijf exportformaten. Kies het abonnement dat bij uw documenten past.

Free

Meld je aan en begin direct

$0/ maand

Geen betaalmethode vereist

  • 5 gratis pagina's elke dag
  • PDF, Word, PPT, Excel, afbeeldingen, HTML
  • Bestanden tot 10 MB · afbeeldingen tot 5 MB
  • PDF's tot 5 pagina's
  • Webtoegang; API is niet inbegrepen
Begin gratis

Pro · Maandelijks

Flexibele toegang, één maand per keer

$9.90/ maand

USD · eenmalige betaling

  • 1,000 pagina's elke maand
  • PDF, Word, PPT, Excel, afbeeldingen, HTML
  • Bestanden tot 200 MB · afbeeldingen tot 50 MB
  • PDF's tot 500 pagina's
  • API toegang inbegrepen
Kies maandelijks

Pro omvat ook de dagelijkse gratis hoeveelheid. Maandelijkse pagina's worden elke maand gereset en stapelen zich niet op. Uitvoer wordt 7 dagen bewaard.

Op locatie

Uw gegevens verlaten uw pand nooit

Voor financiële instellingen, gezondheidszorg, overheid en onderzoeksinstellingen wordt PaddleOCR volledig on-premise ingezet: modellen en gegevens draaien volledig binnen uw eigen netwerk.

100%Gegevens blijven lokaal
ConformBeveiligingsframework klaar
24/7Toegewijde ondersteuning
Praat met ons over de inzet

Klantverhalen

  • Een toonaangevend effectenonderzoeksinstituutPrivé-parsing voor een interne onderzoekskennisbank — 50,000 pagina's per dag zonder gegevensuitvoer.
  • Een onderzoeksafdeling van een tertiair ziekenhuisGestructureerde extractie uit medische literatuur en onderzoeksrapporten, volledig in overeenstemming met de regels voor onderzoeksdata.
  • Een provinciale overheidswolkGedigitaliseerde archieven van officiële documenten die intelligent zoeken en vragen en antwoorden mogelijk maken.
Een IT-beheerder en een onderzoeker die documentgegevens beheren in een lokale serverruimte
Modellen en gegevens blijven binnen uw eigen netwerk en voldoen aan de compliance-eisen in de financiële wereld, de gezondheidszorg en de overheid.