PaddleOCR Online · Nie instaluj, otwórz i gotowe

Konwertuj dowolny dokument
na Markdown

Od plików PDF i skanów po Word, Excel i PowerPoint — PaddleOCR odczytuje wszystkie te formaty i odtwarza nagłówki, akapity, tabele, wzory i wykresy w oryginalnej kolejności czytania. Generuje Markdown i JSON ze współrzędnymi, przywraca wzory jako LaTeX, a struktury molekularne jako SMILES, zachowując kompletność tabel także przy podziale na strony i scalonych komórkach. Obsługuje ponad 100 języków, a modele działają w chmurze i są dostępne do wywołania w dowolnej chwili. Dzięki dostępowi przez API skonfigurowanie potoku wprowadzania dokumentów do bazy danych zajmuje zaledwie minutę.

Strony analizowane codziennie
1.2M+
Strony analizowane codziennie
Obsługiwane formaty
30+
Formaty plików i sieci
Czas pracy usługi
99.9%
Czas pracy usługi

PaddleOCR Obszar roboczy

Przesyłanie · analizowanie · eksportowanie, wszystko w jednym miejscu

PDF / DOCX / PPTX / XLSX / HTML / PNG

pliki do 10 MB · obrazy do 5 MB · Pliki PDF do 5 stron Uaktualnij do wersji Pro Dostępne

Tylko PDF. Włączone: pomiń warstwę tekstową i użyj OCR. Wyłączone: rozpoznawanie automatyczne. Inne formaty pozostają bez zmian.
Formaty eksportu Markdown · JSON · HTML · DOCX · LaTeX
Zaloguj się, aby zobaczyć swoje zadania

Twoje dokumenty i wyniki należą do Twojego konta.

Zaloguj się

Analiza w akcji

Zobacz, co wraca z prawdziwej strony

Po wręczeniu tego samego dokumentu ogólny OCR wyświetli ścianę tekstu. PaddleOCR zachowuje strukturę, chemię i matematykę.

Przypadek 01 · Struktury chemiczne

Schemat molekularny → chemia możliwa do przeszukiwania i obliczania

Struktury nie są już wyrzucane jako obrazy. PaddleOCR odczytuje układy pierścieni i podstawniki, a następnie emituje SMILES, wzory molekularne i LaTeX.

Oryginalna strona PDF
Scheme 2. J. Med. Chem. 2026, 49, 1128 Fig. 2. Structure of paracetamol HO NHCOCH3
Wyjście PaddleOCR
>
# structure → structured chemistry

{

  "type": "chemical_structure",

  "smiles": "CC(=O)Nc1ccc(O)cc1",

  "formula": "C8H9NO2",

  "iupac": "N-(4-hydroxyphenyl)acetamide",

  "latex": "\ce{CH3CONH-C6H4-OH}"

}


# inline Markdown output

Paracetamol ($C_8H_9NO_2$, SMILES: CC(=O)Nc1ccc(O)cc1)
Ogólny OCRDiagram zostaje usunięty jako obraz — jedyne, co przetrwa, to „patrz rys. 2”. Bez wyszukiwania, bez obliczeń.
PaddleOCROdzyskany jako SMILES / formuła / LaTeX — gotowy do indeksowania, wykonywania zapytań i wykonywania obliczeń właściwości.
Przypadek 02 · Matematyka

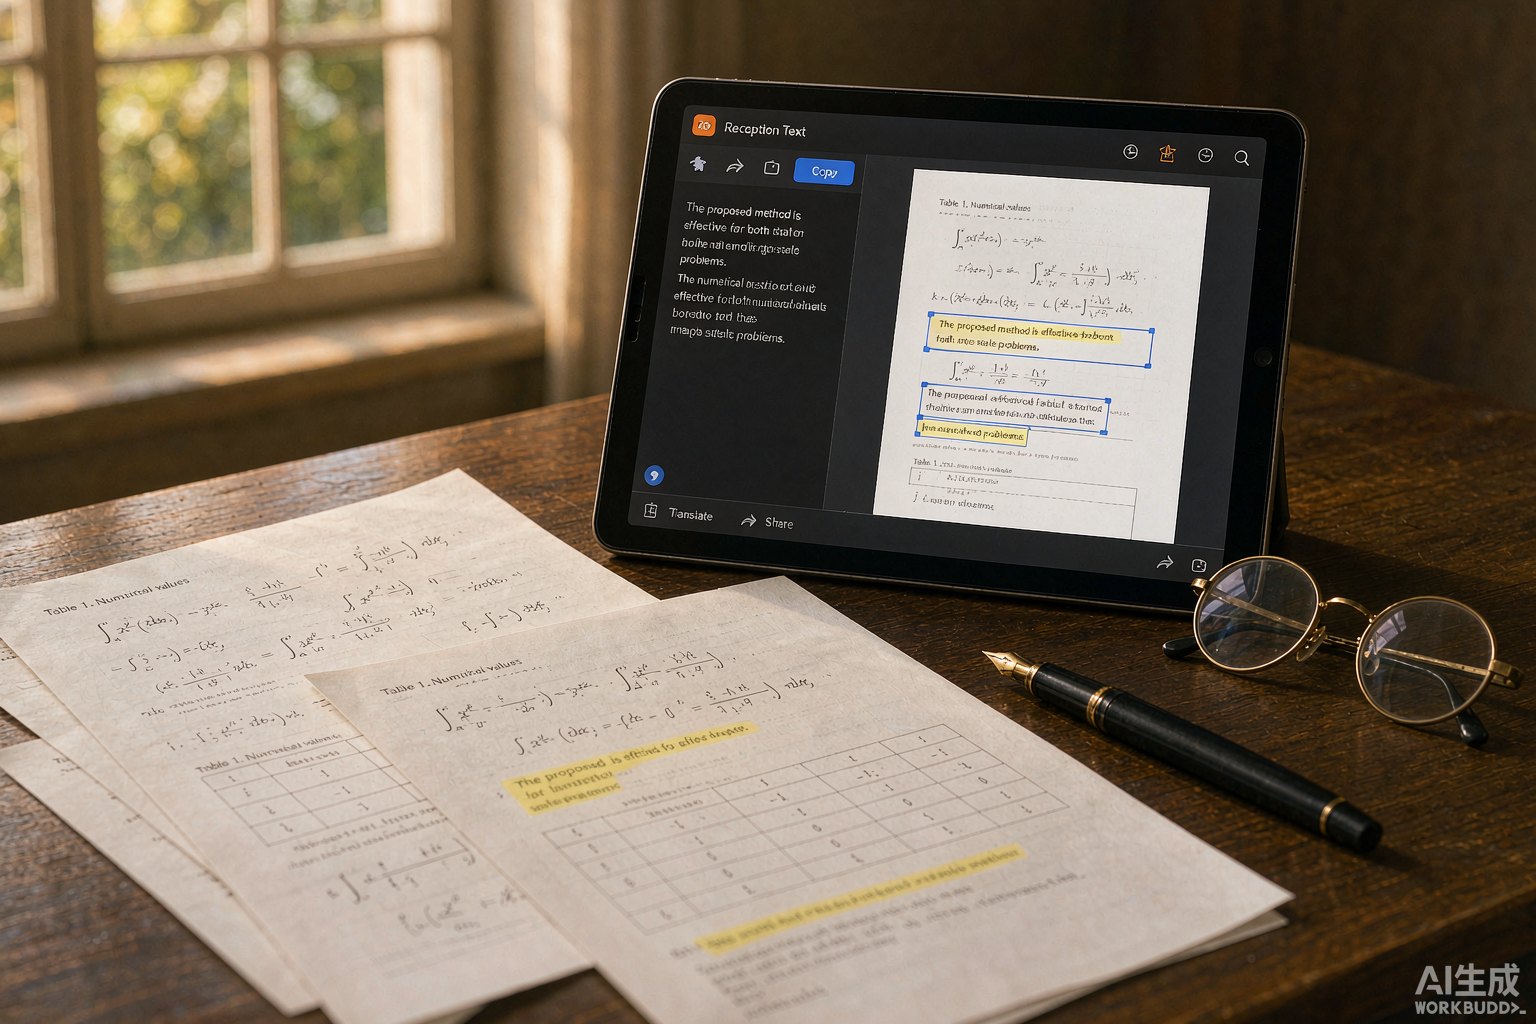
Formuły → wyczyść LaTeX

Indeksy dolne, rodniki, ułamki zwykłe i litery greckie pozostają nienaruszone — dane wyjściowe są kompilowane w niezmienionej postaci.

Oryginalna strona PDF
Wyjście PaddleOCR
>
# standard LaTeX, renders as-is

\int_{0}^{\infty} e^{-x^{2}}\,dx

= \frac{\sqrt{\pi}}{2}


\frac{\pi^{2}}{6}

= \sum_{n=1}^{N} \frac{1}{n^{2}}


# human-readable text kept too

∫₀^∞ e^(−x²) dx = √π / 2
Przypadek 03 · Złożone tabele

Połączone nagłówki i tabele rozpinające → wiersze strukturalne

Wielopoziomowe nagłówki i tabele, które rozciągają się na kolejnych stronach, są ponownie zszyte, z nienaruszonymi współrzędnymi komórek.

Oryginalna strona PDF
Table 3. Yield comparison, control vs. treatment Group Control Treatment Mean SD Mean SD Sample A 12.4 0.83 18.9 1.02 Sample B 14.1 0.91 21.3 1.14 Sample C 15.7 1.05 24.6 1.28 Sample D 17.2 1.11 26.8 1.35
Wyjście PaddleOCR
>
# merged headers flattened to Markdown

| Group | Control mean | Control SD | Treatment mean | Treatment SD |

| --- | ---:| ---:| ---:| ---:|

| Sample A | 12.4 | 0.83 | 18.9 | 1.02 |

| Sample B | 14.1 | 0.91 | 21.3 | 1.14 |

| Sample C | 15.7 | 1.05 | 24.6 | 1.28 |

| Sample D | 17.2 | 1.11 | 26.8 | 1.35 |


# coordinates & merges kept in JSON

{"rows": 5, "cols": 5, "merged": [2, 2]}

Możliwości

Silnik analizujący zbudowany dla złożonych dokumentów

Poza ekstrakcją tekstu. PaddleOCR rozumie strukturę, semantykę i hierarchię układów naukowych.

Chemia · matematyka · tabele

01 / NAUKA

Rozumienie układu naukowego

Zaprojektowany specjalnie do formuł chemicznych, notacji matematycznej, złożonych tabel i układów wielokolumnowych — zachowując porządek czytania i strukturę logiczną.

Wzory chemiczneLaTeX matematykaTabele rozpinające
{ "type" : "title" , "level" : 1 "bbox" : [ 72, 96, 540 ], "text" : "3. Methods" }, "type" : "table" , "html" : "<table>…" }, …] Semantyka · bbox · hierarchia

02 / AGENCI

Natywny dla agentów AI

Strukturalny JSON ze znacznikami semantycznymi dla nagłówków, akapitów, tabel, rysunków i formuł — podłączaj bezpośrednio do RAG, baz wiedzy i przepływów pracy agentów.

Strukturalny JSONRAG-gotoweTagi semantyczne
Layout 0.42s Formulas 0.61s Tables 0.77s 100 stron · Łącznie 1.8s

03 / PRĘDKOŚĆ

Szybkie obliczenia elastyczne

Elastyczne planowanie w chmurze analizuje stustronicowe dokumenty w ciągu kilku sekund, podczas gdy zadania wsadowe działają równolegle, aby sprostać przepustowości przedsiębiorstwa.

Praca na pół sekundyPartie równoległeSkalowanie elastyczne

Kto używa PaddleOCR

Stworzony dla zespołów badawczych, inżynieryjnych i biznesowych

Od listy lektur jednej osoby po bazę wiedzy obejmującą całą organizację, PaddleOCR znajduje się przy pierwszej bramce, przez którą dokumenty trafiają do Twoich systemów.

Badacz używający PaddleOCR online do analizowania PDF artykułów i literatury na tekst strukturalny

Naukowcy

Badacze naukowi

Zbiorcze przekształcanie dokumentów, patentów i notatek laboratoryjnych w ustrukturyzowany tekst z możliwością przeszukiwania. Wzory i zapis chemiczny pozostają nienaruszone, więc recenzje literatury nie są już transkrypcją ręczną.

Programista wywołuje dokument PaddleOCR analizujący API i podłączający wyniki do aplikacji

Programiści

Twórcy aplikacji AI

Jedna linia kodu. Uzyskaj semantyczny tag JSON bezpośrednio do potoku RAG, bazy wiedzy lub przepływu pracy agenta — bez konieczności utrzymywania własnego potoku analizowania.

Zespół przeglądający analizy analizy dokumentów i pulpity nawigacyjne na dużym ekranie sali konferencyjnej

Przedsiębiorstwo

Zespoły korporacyjne i instytucjonalne

Raporty z badań, umowy i archiwa pobierane wsadowo. Połącz go z lokalnymi raportami dotyczącymi wdrażania i użytkowania, aby umożliwić rzeczywiste przeszukiwanie zasobów dokumentów.

API odniesienie

Zintegruj w jednej linii, wywołaj ją jak funkcję lokalną

RESTful API i wielojęzyczny SDKs obejmują przesyłanie, status i pobieranie — z przejrzystymi kodami błędów i webhookami, dzięki czemu integracja pozostaje bezproblemowa.

  • RESTful punkty końcowe z przykładami cURL / Python / Node.js / Go
  • Wybierz odpowiedzi synchroniczne lub zadania asynchroniczne
  • Ustrukturyzowane kody błędów ze wskazówkami dotyczącymi ponownej próby
  • Wywołania zwrotne webhooka po zakończeniu, nie jest potrzebne odpytywanie
Przeczytaj pełną dokumentację API
>
import requests

api = "https://api.example.com/api/open/v1"
headers = {"Authorization": "Bearer YOUR_API_KEY"}
with open("paper.pdf", "rb") as file:
    response = requests.post(api + "/tasks", headers=headers,
        files={"file": ("paper.pdf", file, "application/pdf")},
        data={"force_ocr": "true", "extra_formats": '["docx","html"]'})
response.raise_for_status()
body = response.json()
if body["code"] != 0: raise RuntimeError(body["msg"])
task = body["data"]
print(task["task_id"])
# GET /tasks/{id}; download results.full_zip_url when completed

Ceny

Wybierz według sposobu użytkowania, przełącz w dowolnym momencie

Analiza online i wszystkie pięć formatów eksportu. Wybierz plan pasujący do Twoich dokumentów.

Free

Zarejestruj się i zacznij od razu

$0/ miesiąc

Metoda płatności nie jest wymagana

  • 5 darmowe strony każdego dnia
  • PDF, Word, PPT, Excel, obrazy, HTML
  • Pliki do 10 MB · obrazy do 5 MB
  • Pliki PDF do 5 stron
  • Dostęp do sieci; API nie jest uwzględniony
Zacznij bezpłatnie

Pro · Miesięcznie

Elastyczny dostęp przez jeden miesiąc

$9.90/ miesiąc

USD · płatność jednorazowa

  • 1,000 stron co miesiąc
  • PDF, Word, PPT, Excel, obrazy, HTML
  • Pliki do 200 MB · obrazy do 50 MB
  • Pliki PDF do 500 stron
  • API dostęp wliczony w cenę
Wybierz plan miesięczny

Pro obejmuje również bezpłatny dzienny dodatek. Strony miesięczne resetują się co miesiąc i nie kumulują się. Wyniki są przechowywane przez 7 dni.

Lokalnie

Twoje dane nigdy nie opuszczają Twojej siedziby

W przypadku instytucji finansowych, opieki zdrowotnej, rządowych i badawczych PaddleOCR wdraża w pełni lokalnie: modele i dane działają całkowicie w Twojej własnej sieci.

100%Dane pozostają lokalne
ZgodnyGotowa struktura bezpieczeństwa
24/7Dedykowane wsparcie
Porozmawiaj z nami o wdrożeniu

Historie klientów

  • Najwyższej klasy instytut badań nad papierami wartościowymiPrywatna analiza wewnętrznej bazy wiedzy badawczej — 50,000 stron dziennie przy zerowym wyjściu danych.
  • Dział badawczy szpitala trzeciego stopniaUstrukturyzowana ekstrakcja literatury medycznej i raportów z badań, w pełni zgodna z zasadami danych badawczych.
  • Chmura rządu prowincjiCyfrowe archiwa oficjalnych dokumentów umożliwiające inteligentne wyszukiwanie oraz funkcję pytań i odpowiedzi.
Administrator IT i badacz zarządzający danymi dokumentów w lokalnej serwerowni
Modele i dane pozostają w Twojej własnej sieci, spełniając wymogi zgodności w finansach, opiece zdrowotnej i rządzie.