PaddleOCR Онлайн · Не требует установки, открывай и работай

Любой документ
в Markdown

От PDF и сканов до Word, Excel и PowerPoint — PaddleOCR читает все эти форматы и восстанавливает заголовки, абзацы, таблицы, формулы и диаграммы в исходном порядке чтения. Результат — Markdown и JSON с координатами, формулы в LaTeX и молекулярные структуры в SMILES. Таблицы сохраняются целиком, в том числе при переносе между страницами и с объединёнными ячейками. Поддерживается более 100 языков, а модели работают в облаке и доступны для вызова в любое время. С помощью API можно настроить конвейер загрузки документов в базу данных всего за одну минуту.

Страницы анализируются ежедневно.
1.2M+
Страницы анализируются ежедневно.
Поддерживаемые форматы
30+
Файловые и веб-форматы
Время работы службы
99.9%
Время работы службы

PaddleOCR Рабочая область

Загрузка · анализ · экспорт, все в одном месте

PDF / DOCX / PPTX / XLSX / HTML / PNG

файлы до 10 MB · изображения до 5 MB · PDF-файлы до 5 страниц Обновите до Pro

Только для PDF. Включено: игнорировать текстовый слой и использовать OCR. Выключено: определять автоматически. Другие форматы не затрагиваются.
Форматы экспорта Markdown · JSON · HTML · DOCX · LaTeX
Войдите, чтобы увидеть свои задачи.

Ваши документы и результаты принадлежат вашей учетной записи.

Войти

Парсинг в действии

Посмотрите, что возвращается с реальной страницы.

Если передать тот же документ, стандартное OCR выдаст вам стену текста. PaddleOCR сохраняет структуру, химию и математику.

Случай 01 · Химические структуры

Молекулярная диаграмма → вычислимая химия с возможностью поиска

Структуры больше не выбрасываются как изображения. PaddleOCR считывает кольцевые системы и заместители, затем выделяет SMILES, молекулярные формулы и LaTeX.

Исходная страница PDF
Scheme 2. J. Med. Chem. 2026, 49, 1128 Fig. 2. Structure of paracetamol HO NHCOCH3
PaddleOCR вывод
>
# structure → structured chemistry

{

  "type": "chemical_structure",

  "smiles": "CC(=O)Nc1ccc(O)cc1",

  "formula": "C8H9NO2",

  "iupac": "N-(4-hydroxyphenyl)acetamide",

  "latex": "\ce{CH3CONH-C6H4-OH}"

}


# inline Markdown output

Paracetamol ($C_8H_9NO_2$, SMILES: CC(=O)Nc1ccc(O)cc1)
Общее распознавание текстаДиаграмма удаляется как изображение — остаётся только «см. рис. 2». Никакого поиска, никаких вычислений.
PaddleOCRВосстановлено как SMILES/formula/LaTeX — готово для индексации, запроса и выполнения вычислений свойств.
Случай 02 · Математика

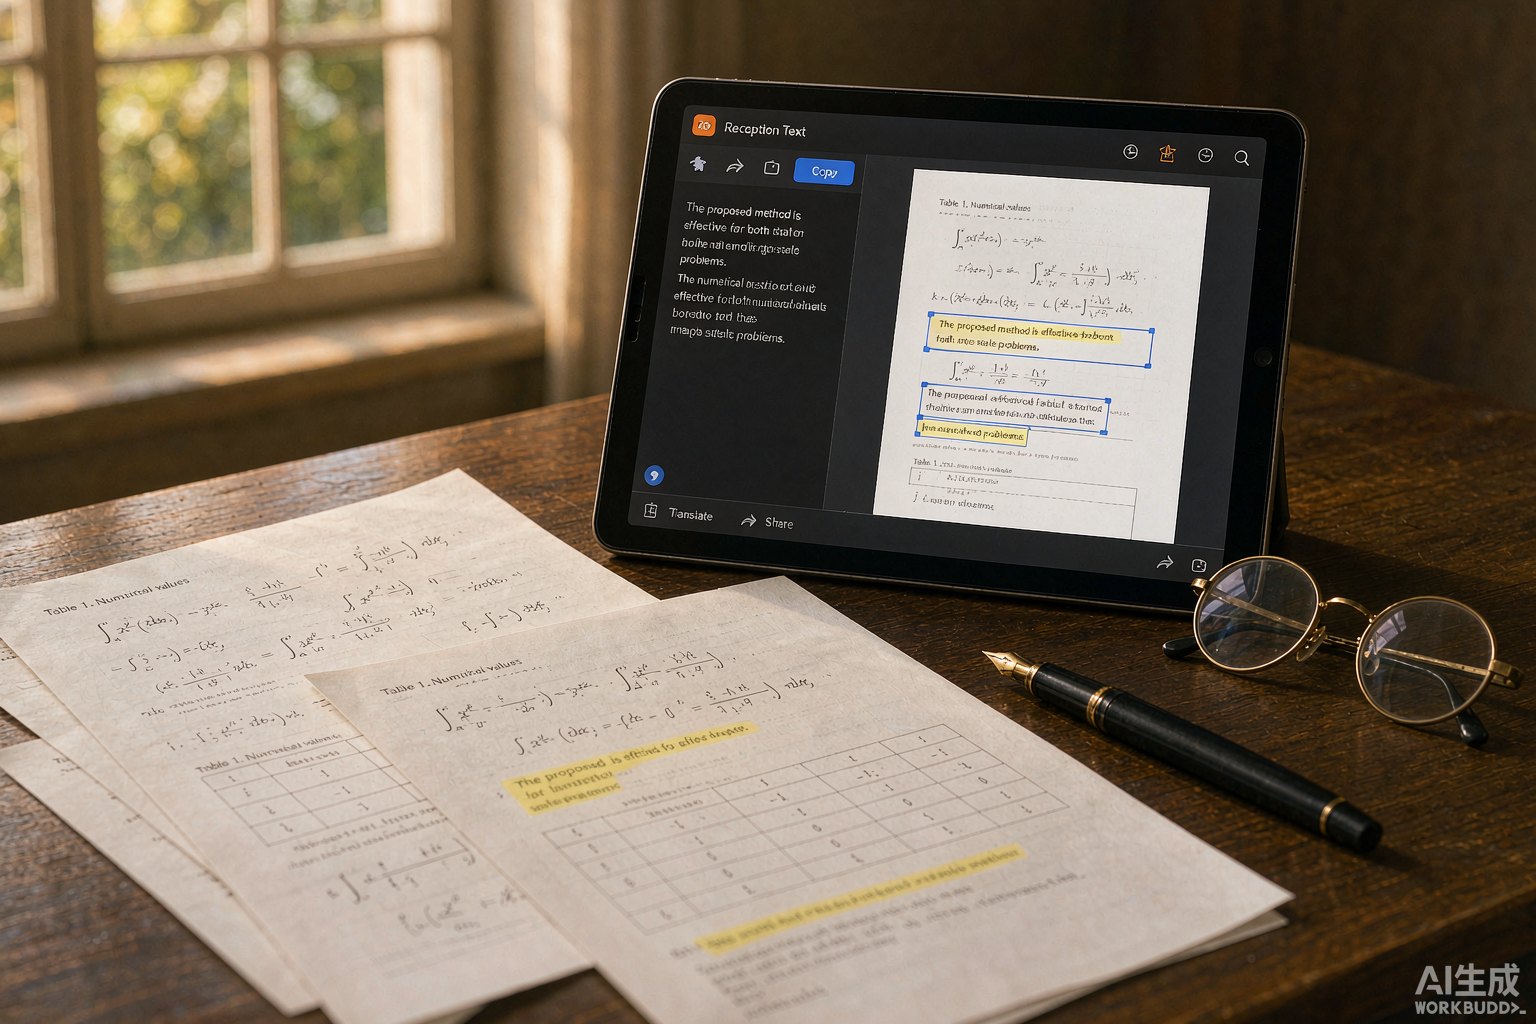
Формулы → очистить LaTeX

Индексы, радикалы, дроби и греческие буквы сохраняются без изменений — выходные данные компилируются как есть.

Исходная страница PDF
PaddleOCR вывод
>
# standard LaTeX, renders as-is

\int_{0}^{\infty} e^{-x^{2}}\,dx

= \frac{\sqrt{\pi}}{2}


\frac{\pi^{2}}{6}

= \sum_{n=1}^{N} \frac{1}{n^{2}}


# human-readable text kept too

∫₀^∞ e^(−x²) dx = √π / 2
Случай 03 · Сложные таблицы

Объединенные заголовки и связующие таблицы → структурированные строки

Многоуровневые заголовки и таблицы, которые продолжаются на всех страницах, сшиваются вместе, сохраняя координаты ячеек.

Исходная страница PDF
Table 3. Yield comparison, control vs. treatment Group Control Treatment Mean SD Mean SD Sample A 12.4 0.83 18.9 1.02 Sample B 14.1 0.91 21.3 1.14 Sample C 15.7 1.05 24.6 1.28 Sample D 17.2 1.11 26.8 1.35
PaddleOCR вывод
>
# merged headers flattened to Markdown

| Group | Control mean | Control SD | Treatment mean | Treatment SD |

| --- | ---:| ---:| ---:| ---:|

| Sample A | 12.4 | 0.83 | 18.9 | 1.02 |

| Sample B | 14.1 | 0.91 | 21.3 | 1.14 |

| Sample C | 15.7 | 1.05 | 24.6 | 1.28 |

| Sample D | 17.2 | 1.11 | 26.8 | 1.35 |


# coordinates & merges kept in JSON

{"rows": 5, "cols": 5, "merged": [2, 2]}

Возможности

Механизм синтаксического анализа, созданный для сложных документов.

Помимо извлечения текста. PaddleOCR понимает структуру, семантику и иерархию научных макетов.

Химия · математика · таблицы

01 / НАУКА

Понимание научной компоновки

Специально разработан для химических формул, математических обозначений, сложных таблиц и макетов из нескольких столбцов — с сохранением порядка чтения и логической структуры.

Химические формулыLaTeX математикаОбъединение таблиц
{ "type" : "title" , "level" : 1 "bbox" : [ 72, 96, 540 ], "text" : "3. Methods" }, "type" : "table" , "html" : "<table>…" }, …] Семантика · bbox · иерархия

02 / АГЕНТЫ

Родной для агентов ИИ.

Структурированный JSON с семантическими тегами для заголовков, абзацев, таблиц, рисунков и формул — подключайтесь напрямую к RAG, базам знаний и рабочим процессам агентов.

Структурированный JSONRAG-готовоСемантические теги
Layout 0.42s Formulas 0.61s Tables 0.77s 100 страниц · всего 1.8с

03 / СКОРОСТЬ

Высокоскоростные эластичные вычисления

Эластичное облачное планирование анализирует документы объемом в сотни страниц за секунды, а пакетные задания выполняются параллельно, чтобы обеспечить пропускную способность предприятия.

Второстепенные заданияПараллельные партииЭластичное масштабирование

Кто использует PaddleOCR

Создан для исследовательских, инженерных и бизнес-команд.

От списка чтения одного человека до базы знаний всей организации — PaddleOCR находится у первых ворот, через которые документы попадают в ваши системы.

Научный исследователь, использующий PaddleOCR онлайн для анализа PDF статей и литературы в структурированный текст.

Исследователи

Научные исследователи

Превратите документы, патенты и лабораторные записи в групповой структурированный текст с возможностью поиска. Формулы и химические обозначения сохраняются без изменений, поэтому обзоры литературы перестают быть расшифровкой вручную.

Разработчик вызывает документ PaddleOCR, анализирует API и передает результаты в приложение.

Разработчики

Разработчики приложений искусственного интеллекта

Одна строка кода. Добавляйте семантические теги JSON прямо в свой конвейер RAG, базу знаний или рабочий процесс агента — вам не придется поддерживать собственный конвейер синтаксического анализа.

Команда просматривает аналитику анализа документов и информационные панели на большом экране в конференц-зале.

Предприятие

Корпоративные и институциональные команды

Пакетный ввод отчетов об исследованиях, контрактов и архивов. Объедините его с отчетами о локальном развертывании и использовании, чтобы сделать активы документов действительно доступными для поиска.

API ссылка

Интегрируйте в одну строку, вызывайте как локальную функцию

RESTful API и многоязычный SDKs охватывают загрузку, состояние и загрузку — с четкими кодами ошибок и веб-перехватчиками, поэтому интеграция остается безболезненной.

  • RESTful конечные точки с примерами cURL / Python / Node.js / Go
  • Выберите синхронные ответы или асинхронные задания.
  • Структурированные коды ошибок с рекомендациями по повторной попытке.
  • Обратные вызовы Webhook по завершении, опрос не требуется.
Прочтите полную документацию API.
>
import requests

api = "https://api.example.com/api/open/v1"
headers = {"Authorization": "Bearer YOUR_API_KEY"}
with open("paper.pdf", "rb") as file:
    response = requests.post(api + "/tasks", headers=headers,
        files={"file": ("paper.pdf", file, "application/pdf")},
        data={"force_ocr": "true", "extra_formats": '["docx","html"]'})
response.raise_for_status()
body = response.json()
if body["code"] != 0: raise RuntimeError(body["msg"])
task = body["data"]
print(task["task_id"])
# GET /tasks/{id}; download results.full_zip_url when completed

Цены

Выбирайте по использованию, переключайтесь в любое время

Онлайн-парсинг и все пять форматов экспорта. Выберите план, который соответствует вашим документам.

Free

Зарегистрируйтесь и начните прямо сейчас

$0/ месяц

Способ оплаты не требуется.

  • 5 бесплатных страниц каждый день
  • PDF, Word, PPT, Excel, изображения, HTML
  • Файлы до 10 MB · изображения до 5 MB
  • PDF-файлы объемом до 5 страниц.
  • Доступ в Интернет; API не включен
Начать бесплатно

Pro · На месяц

Гибкий доступ, по месяцу.

$9.90/ месяц

USD · единоразовый платеж

  • 1,000 страниц каждый месяц
  • PDF, Word, PPT, Excel, изображения, HTML
  • Файлы до 200 MB · изображения до 50 MB
  • PDF-файлы объемом до 500 страниц.
  • Доступ API включен
Выбрать месяц

Pro также включает ежедневную бесплатную норму. Ежемесячные страницы сбрасываются каждый месяц и не накапливаются. Выводы сохраняются в течение 7 дней.

Локально

Ваши данные никогда не покинут ваше помещение.

Для финансовых, медицинских, государственных и исследовательских учреждений PaddleOCR развертывается полностью локально: модели и данные полностью работают внутри вашей собственной сети.

100%Данные остаются локальными.
СоответствуетГотовая система безопасности
24/7Выделенная поддержка
Поговорите с нами о развертывании.

Истории клиентов

  • Ведущий исследовательский институт ценных бумаг.Частный анализ для внутренней исследовательской базы знаний — 50,000 страниц в день с нулевым выходом данных.
  • Исследовательский отдел больницы третичного уровня.Структурированное извлечение данных из медицинской литературы и отчетов об исследованиях, полностью соответствующее правилам использования данных исследований.
  • Облако правительства провинции.Оцифрованные архивы официальных документов, обеспечивающие интеллектуальный поиск и вопросы и ответы.
ИТ-администратор и исследователь, управляющие данными документов в локальной серверной комнате.
Модели и данные остаются внутри вашей собственной сети, что соответствует требованиям соответствия в сфере финансов, здравоохранения и государственного управления.